20.11.2026 à 07:00
Tokenomics : le puits sans fond de l’économie des tokens
Hubert Guillaud
Texte intégral (2006 mots)
Comprendre et maîtriser l’économie des tokens est devenu un enjeu pour nombre d’entreprises qui utilisent les modèles d’IA les plus avancés, et qui paient à la consommation (voir notre précédent article sur le sujet). Si l’on en croit l’index de référence, le LLM Token Expenditure index, développé par Silicon Data, celui-ci est tombé sous la barre du dollar par million de token début septembre 2026, pour la première fois. Si le prix est à la baisse, les grands utilisateurs d’IA paient pourtant des factures de plus en plus élevées, notamment du fait de la prolifération des workflows agentiques, rapporte le Financial Times. « Cela a radicalement modifié la dynamique de tarification, renforçant l’imprévisibilité. « Selon la complexité de la tâche, la consommation de tokens sera nettement plus élevée. » Résultat, les montants facturés sont bien plus importants. »
« L’augmentation des dépenses liées à l’IA a mis en lumière l’ampleur de la puissance de calcul consommée quotidiennement par les entreprises : les investissements globaux ont connu une croissance exponentielle. Ramp, une plateforme de gestion des fournisseurs d’IA, indique que les dépenses consacrées à l’IA ont été multipliées par près de six au cours des 18 mois précédant juin 2026, les entreprises consommant davantage de jetons pour accomplir des tâches plus complexes. Les dépenses totales des entreprises en matière de puissance de calcul pour l’IA ont progressé de 60 % au cours des neuf derniers mois, estime JP Morgan. Même les entreprises plus traditionnelles augmentent leurs dépenses. Selon Ramp, la dépense médiane par employé et par mois est passée de 2,86 $ en janvier 2024 à 11,95 $ en juillet 2026. Pour le 1 % des entreprises qui dépensent le plus – celles qui ont pleinement adopté cette technologie -, cette dépense médiane est passée de 755 $ à 7 400 $. JP Morgan, s’appuyant sur des données publiées en juin par Ramp AI, précise que ce 1 % des utilisateurs d’IA – généralement ceux qui effectuent des tâches de programmation complexes – consomme 600 fois plus de jetons qu’un utilisateur médian. » Et cela ne va pas s’arrêter là : « la consommation de jetons va continuer de croître et les prix vont augmenter, notamment en raison des introductions en bourse imminentes d’Anthropic et d’OpenAI, qui rendront ces entreprises comptables de leurs résultats auprès des investisseurs ».
L’impératif de rentabilité pour les modèles d’IA de pointe a transformé la manière dont les entreprises utilisent cette technologie. L’utilisation de l’IA représentant un coût significatif et le retour sur investissement lié à son déploiement devient une préoccupation majeure : « l’époque où l’on pouvait expérimenter librement via des programmes pilotes est révolue », insiste le Financial Times. Mais, « il devient plus complexe d’identifier la valeur réelle générée par des systèmes d’IA toujours plus sophistiqués – et coûteux. Si les agents peuvent accroître la productivité, la complexité croissante de leurs processus de raisonnement et de leur utilisation d’outils pourrait faire en sorte que les coûts finissent par dépasser les bénéfices. » Cette évaluation peut alors passer par la mesure du temps gagné, en comparant les économies réalisées aux dépenses engagées. Elle passe aussi par la maîtrise des coûts, le contrôle des achats de jetons et surtout la comparaison des offres disponibles. Toutes les entreprises ne peuvent pas se permettre de débourser les 300 millions de dollars que Salesforce prévoit de verser à Anthropic en 2026. Or, les différences de performances entre les modèles se stabilisent, permettant d’explorer d’autres options, et notamment beaucoup ont recours à des modèles à poids ouverts de DeepSeek ou Llama de Meta.
« Le Ramp AI Index a révélé qu’en juillet 2026, plus de 6 % des entreprises ayant adopté l’IA utilisaient des modèles à poids ouverts, contre 4,5 % en janvier. » En permettant aux entreprises d’héberger la technologie sur leurs propres serveurs et d’ajuster le système à leurs besoins spécifiques en utilisant leurs propres données propriétaires, ces solutions permettent en partie de mieux maîtriser la chaîne de production.
Un autre moyen pour maîtriser les coûts, consiste à adapter l’outil à la tâche. Nombre de tâches n’ont pas besoin des modèles de pointe. « Les prix des jetons, au sein d’une même famille de modèles, varient considérablement – les modèles Claude facturent de 1 à 10 $ par million de jetons d’entrée et de 4 à 50 $ par million de jetons de sortie -, ce qui signifie que l’utilisation de modèles plus simples peut faire toute la différence. Le routage des modèles, grâce à des logiciels comme OpenRouter, facilite cette démarche en orientant une invite vers le modèle le plus économique en fonction de la complexité du problème. »
Enfin, les entreprises peuvent limiter la tendance à surcharger leurs requêtes d’IA de contexte, comme le propose le PDG de Mindbreeze, un moteur de gestion des connaissances ou encore limiter le recours à de nombreux modèles. L’enjeu : éviter les traitements redondants, par exemple par la mise en cache des requêtes déjà faites, en améliorant le suivi des requêtes et utilisations.
Reste que pour réduire les coûts, il est nécessaire de développer des modèles sur mesure. « Même un modèle à pondération ouverte peut être extrêmement inefficace s’il est très général. On le constate déjà avec les modèles les plus récents comme Kimi (de la société chinoise d’IA Moonshot). Ce sont des modèles à 1 000 milliards paramètres, donc ils sont incroyablement gourmands en ressources de calcul. »
A terme, il est probable que chaque entreprise crée ses propres modèles, pour des raisons de propriété et de rentabilité. « Créer un modèle n’est plus difficile.» « Les entreprises ne veulent plus dépendre d’une poignée de sociétés » et elles s’intéressent désormais davantage au développement interne comme protection contre la hausse du coût des jetons qu’à l’IA souveraine, qui justifiait auparavant l’internalisation.
Que les tokens continuent à être moins chers ou que les tarifs se relèvent pour assurer aux fournisseurs de modèle un retour sur investissement, les entreprises vont quoi qu’il en soit continuer à dépenser de l’argent pour l’IA. Nombre d’entre elles ne considèrent plus l’IA comme une simple charge informatique, mais comme un levier essentiel de leur capacité opérationnelle. « Les équipes de direction commencent à remplacer les coûts de main-d’œuvre traditionnels par des dépenses liées à la consommation de jetons ; une transition qui s’accélère particulièrement dans des secteurs spécialisés, comme le développement logiciel. Pour illustrer l’ampleur de ce basculement, le cabinet de conseil américain Bain estime que les entreprises finiront par réorienter 20 à 30 % de leurs coûts de personnel vers des dépenses en token. » Toutefois, modère le Financial Times, substituer des budgets de masse salariale par des investissements dans une infrastructure de tokens comporte des risques opérationnels. Cette réallocation du capital doit impérativement générer de la valeur.
La banque d’investissement Goldman Sachs a récemment décidé de réserver les outils d’IA à ses seuls ingénieurs, au grand dépit de certains traders, rapporte Bloomberg. JPMorgan Chase a indiqué en juillet qu’elle souhaitait que ses collaborateurs associent chaque tâche à un modèle d’IA approprié ; l’idée est de réserver les options les plus coûteuses aux travaux les plus complexes, plutôt qu’à des tâches simples, comme la synthèse d’un rapport d’analyste.
Dans une billet sponsorisé pour la Technology Review, Affan Syed de Hewlett Packard, la tarification au token conduit à rendre coûteux les flux de travail qui génèrent le plus de valeur. Gartner prévoit que, d’ici 2028, le coût des tokens dans le développement logiciel dépassera le salaire moyen des développeurs. Face à l’envolée des coûts, la réaction instinctive consiste à instaurer des restrictions : plafonds d’utilisation, limitation du nombre d’utilisateurs ou obligation d’obtenir une validation avant le lancement d’un agent. Mais ces limites globales risquent d’entraver les processus qui créent réellement de la valeur. De plus, elles se concentrent sur une métrique inadaptée : le coût par token mesure la consommation, et non les résultats. Un compteur, tout comme un plafond budgétaire, est incapable de faire la distinction entre ce qui relève du gaspillage et ce qui relève de la livraison de logiciels.
Pour Syed, il faut changer de métrique. « Un indicateur plus pertinent est le coût par pull request intégrée : c’est-à-dire le coût total du développement assisté par IA divisé par le nombre de modifications qui passent avec succès l’étape de revue et sont intégrées au code source. Il convient également de suivre le volume de retouches et le nombre de défauts, afin d’éviter que des modifications moins coûteuses ne masquent une baisse de la qualité. Si ce coût diminue à mesure que l’utilisation de l’IA augmente – sans pour autant compromettre la qualité – cela signifie que les développeurs transforment davantage de ressources consommées en logiciels réellement utiles. La question n’est pas de savoir combien de tokens sont consommés, mais quel volume de travail abouti est généré par cet investissement. » Et bien sûr, adapter le modèle à la tâche, explique-t-il, avant de vanter les solutions de HP bien sûr.
Même si tout le secteur s’offusque du piège du rationnement, tout le monde semble s’y contraindre, dans une perspective qui ressemble à une injonction paradoxale, appelant à la fois à maîtriser les coûts tout en encourageant les employés à intégrer davantage l’IA dans leur travail quotidien. Nombre d’entreprises, rapporte Bloomberg, ont plafonné les dépenses par employés et invité les salariés à revenir sur les outils développés en interne.
19.11.2026 à 07:00
L’IA pour faire des économies dans le secteur public ? Pas si sûr !
Hubert Guillaud
Texte intégral (4943 mots)
Comme dans nombre d’États développés, le potentiel de l’IA pour réduire drastiquement les coûts de fonctionnement de l’État fait tourner la tête du gouvernement britannique, explique The Economist. La rationalisation tous azimuts du secteur public grâce à l’IA projette des milliards d’économies. Mais il n’est pas sûr que ces économies se réalisent… non pas parce que le secteur public n’arriverait pas à mobiliser ces outils (ce qui est également possible), mais parce que dans le même temps, les citoyens, eux, ont de plus en plus recours à l’IA pour gérer leurs interactions avec l’administration publique et formulent des exigences croissantes à son égard. « En somme, une course aux armements par IA s’est engagée entre l’État et les citoyens, et rien ne garantit que l’État en sortira vainqueur. » Dans l’administration publique, la course à l’IA entre usagers et administrations risque d’aboutir à la même impasse que l’on constate dans le recrutement, avec des systèmes d’IA qui répondent à d’autres systèmes d’IA ou encore dans le domaine militaire, où la difficulté devient de fournir des munitions pour que les systèmes automatisés s’affrontent entre eux. Au risque d’épuiser les finances publiques non plus dans le salaire d’agents, mais dans le coût des systèmes. Qu’arrivera-t-il quand l’agent IA de la CAF ou de la ville arrivera à court de tokens ?
De la submersion à la saturation
The Economist évoque par exemple le cas de l’urbanisme. « Les autorités britanniques ont mis au point des outils pour accélérer l’approbation des projets de logements en émettant un premier avis sur leur conformité juridique. » Pourtant, les collectivités locales signalent une multiplication des recours générés par IA contre les projets immobiliers. Pour une cinquantaine d’euros, la plateforme Objector AI analyse une masse de documents d’urbanisme, élabore les arguments juridiques d’opposition et rédige un discours destiné à être lu lors d’une réunion publique. Même chose dans le domaine des aides sociales. Le ministère du Travail et des Retraites (Department for Work and Pensions) utilise l’IA pour traiter les demandes et détecter les fraudes. Mais les demandeurs se tournent eux aussi vers des agents conversationnels pour rédiger leurs requêtes et maximiser leurs chances de succès. La note pourrait être salée, estime The Economist : les Britanniques réclament moins d’aides qu’ils n’y ont droit, et c’est quelque 20 milliards de livres qui pourraient être récupérés par les citoyens.
L’IA est utilisée dans d’autres secteurs encore, à l’image de Pelp qui permet de rédiger des lettres pour contester des amendes de stationnement. « La nouvelle loi sur les droits des locataires britanniques (Renters’ Rights Act), qui autorise ces derniers à contester les hausses de loyer devant les tribunaux, constitue une cible de choix pour l’IA ». Partout, le nombre de plaintes déposées auprès des autorités de régulation concernant les avocats, les conseillers financiers et les agents immobiliers est en hausse, d’après les données compilées par Chris Schmitz, de la Hertie School à Berlin, qui a inventé le terme d’« agentic flooding » (submersion agentique). Dans son article de recherche, Schmitz explique que cette submersion est déjà à l’œuvre dans certains services publics et certaines juridictions. Via une matrice de risque, il estime que le risque est plus fort dans les services financièrement avantageux mais complexes que dans d’autres, notamment ceux où l’obtention d’aides était jusqu’à présent difficile à obtenir mais peu rémunératrice et accessible. Une étude sur les usages de Gemini avait ainsi montré qu’environ « 1 % des requêtes adressées à Google Gemini concernent des interactions avec l’administration ». Pour Schmitz, cette submersion consiste en des « pics de volume ou de complexité des demandes reçues, qui mettent à rude épreuve les capacités des services et sont rendus possibles par des agents qui réduisent le coût d’interaction avec ces services ». Cette saturation peut être autant quantitative (augmentation du nombre de demandes) que qualitative (augmentation de la complexité de chaque demande). Et ce alors que de nombreux services ne sont conçus que pour traiter un volume de demande limité. Autre enjeu, souligné par le journaliste Nicolas Kayser-Bril dans son excellente newsletter, Gargantia, bien souvent, ces textes à destination de l’administration rédigés par l’IA sont mieux perçus que les autres, rapporte une étude. Mais ce constat est contrebalancé par une autre, qui montre que le niveau de langue aidait les fonctionnaires à mieux cerner les besoins des administrés, qui exprimaient leurs besoins plus simplement, quand les circonvolutions de l’IA, elles, demandent plus d’attention et donc plus de temps de traitement.
Ces augmentations sont patentes, souvent, lorsque les agents d’IA réduisent les coûts associés aux démarches, c’est-à-dire « lorsque le bénéfice escompté dépasse le coût de la démarche ». Se développe là un modèle économique où s’engouffrent déjà des services, comme ceux évoqués dans l’article de The Economist : « des intermédiaires proposent de gérer des démarches administratives complexes pour le compte des usagers en échange d’une commission sur les prestations obtenues, multipliant ainsi le nombre de demandes adressées aux pouvoirs publics », comme les sociétés de gestion de réclamations, à l’image de DoNotPay. Sans compter que des acteurs malveillants pourraient chercher délibérément à saturer les services, prévient Schmitz. « La saturation des capacités peut entraîner des conséquences opérationnelles directes – telles que l’accumulation de dossiers en attente ou le non-respect des délais de réponse – ainsi que des répercussions budgétaires et politiques plus larges, comme la nécessité d’ajustements budgétaires. Dans leur ensemble, ces effets risquent de dégrader l’expérience des usagers des services publics, un facteur qui détermine fortement la confiance envers le gouvernement. »
Dans son analyse de plusieurs services publics pour tenter de mesurer ce phénomène, Schmitz montre que les domaines où la submersion agentique est la plus forte sont la justice et les services juridiques, les plaintes réglementaires, ainsi que les prestations et la protection sociale. Dans la majeure partie des cas étudiés, la submersion survient lorsque des modèles de langage permettent de générer, à faible coût, des textes juridiquement élaborés. Et c’est notamment le cas quand les services acceptent des textes de longueur libre, comme dans les demandes d’accès aux documents administratifs, les consultations d’urbanisme ou les commentaires publics. En élaborant une matrice de risque, le chercheur montre « que le risque à court terme est le plus élevé pour les services financièrement lucratifs impliquant des applications complexes et des obligations légales de traitement, comme les déclarations de revenus ». C’est le cas des contestations d’évaluations fiscales, des recours devant les tribunaux des affaires sociales et des actions civiles. « Ces cas partagent deux caractéristiques. Premièrement, chaque soumission aboutit à des conséquences individuelles significatives : elle représente un gain financier pour le requérant en cas de succès et déclenche une obligation légale de traitement ».
Freiner la submersion ?
Face à ces risques, l’article recense également les options de réponses disponibles. D’un côté, l’enjeu peut être de freiner la demande, par exemple en demandant des frais de dépôt, des limitations de volume des textes libres, ou l’obligation d’un dépôt physique. De l’autre, cela consiste à accroître les capacités des services pour faire face aux pics, en repensant l’interface des services, en augmentant le nombre de personnels ou en déployant des systèmes d’analyses et de réponse par IA. Si les deux approches sont souvent suffisantes, la suppression de la demande est bien plus rapide à mettre en œuvre et risque donc d’être une des réponses privilégiées. Or, elle « diminue la qualité et l’accessibilité des services publics » et peut renforcer les inégalités d’accès, alors qu’elles ont déjà tendance à se développer. Le risque est de rendre les démarches plus difficiles, comme on l’a déjà vu dans les évolutions des services clients.
Selon le chercheur, les services publics devraient surtout « auditer la vulnérabilité de leurs services à ces risques, intégrer l’identité numérique aux services les plus exposés ou plafonner les demandes ». D’autres modalités sont également mobilisables, comme d’interdire aux intermédiaires de percevoir des frais pour certains types de demandes.
Le problème, rappelle Schmitz, c’est que « l’introduction de freins réduit l’accessibilité des services publics. Ces obstacles dissuadent de manière disproportionnée les utilisateurs les plus démunis, ceux qui maîtrisent moins bien les outils numériques ou ceux qui sont vulnérables à d’autres égards, influençant ainsi concrètement l’accès aux services publics ». En voulant réduire la submersion, le risque est fort de renforcer encore un peu plus l’inégalité d’accès aux services publics, qui n’est déjà pas en grande forme. Pour Schmitz, l’autre solution consiste à réduire les avantages que les usagers peuvent obtenir par leurs recours (comme de plafonner ou réduire le montant des recours, restreindre les critères d’éligibilité ou alourdir le coût des demandes infructueuses), mais là encore, c’est au détriment des services publics eux-mêmes. Enfin, les services peuvent également accroître leurs capacités de traitement, mais dans le moment austéritaire actuel, il est peu probable que ce soit la réponse la plus simple à mettre en place. Quant au développement de systèmes d’IA pour répondre aux demandes des usagers produites avec l’IA, le risque est fort de développer une administration automatisée, où tout sens se délite. Pour Schmitz, le risque est fort que la réponse soit de l’ordre du « tâtonnement » : « une adaptation itérative, à court terme et principalement réactive, qui permet aux organisations gouvernementales de rester opérationnelles, mais n’optimise généralement pas les résultats pour le public ». Certains chercheurs théorisent l’arrivée d’une « bureaucratie congestionnée », où les risques socio-politiques prennent le pas et renforcent encore les biais, discriminations et défaillances des modèles, en renforçant l’opacité des processus institutionnels et en altérant jusqu’à leurs capacités de fonctionnement.
Selon The Economist, le Royaume-Uni pourrait être particulièrement exposé à ce phénomène, car les services publics acceptent souvent des soumissions en texte libre, un format que l’IA excelle à rédiger. Toutefois, cette tendance dépasse les frontières britanniques. Dans son rapport annuel, la médiatrice de l’Union européenne, Teresa Anjinho, a constaté que le nombre de saisies via l’IA a augmenté et a mis en place des systèmes d’IA pour répondre à l’afflux. En France, rapportait La Tribune, le vice-président du Conseil d’Etat, Marc Guillaume, rappelait récemment l’envolée des recours au tribunal administratif (passant de 257 000 en 2023 à 370 000 sur les douze derniers mois, sans les attribuer à l’IA d’ailleurs), mais plaidait pour la mobilisation de systèmes d’IA pour mieux organiser les réponses de l’administration pour répondre à « un tsunami contentieux ». Une impulsion que pourraient suivre les juges administratifs, souligne l’avocat spécialiste du contentieux public Nicolas Hervieu sur Bluesky en relevant un récent jugement pour recours abusif infligée à une requérante soupçonnée d’avoir eu recours à l’IA pour produire un recours infondé et stéréotypé. Une amende qui ne sanctionne pas l’usage de l’IA, mais bien le recours abusif.
D’ailleurs, il n’y a pas toujours besoin d’IA pour générer des submersions problématiques, comme le montre le repas à un euro pour les étudiants qui mettent à mal les capacités des Crous à y répondre. Les changements législatifs ouvrent souvent des failles qui nécessitent d’adapter les moyens de réponse rapidement sans que ce soit toujours facile ou prévu.
Le phénomène se retrouve également bien au-delà. « L’autorité canadienne de protection de la vie privée et les tribunaux du travail australiens attribuent à l’IA la forte augmentation des réclamations. Une municipalité néerlandaise a signalé une hausse de 400 % des contestations concernant l’évaluation de la valeur des biens immobiliers (base de la taxe foncière) après le lancement d’une plateforme d’IA commerciale destinée à formuler des recours.» Le journaliste Nicolas Kayser-Bril évoque d’autres exemples encore, comme ceux des tribunaux des affaires sociales de Hambourg jusqu’au médiateur de l’assurance en France en passant par les candidatures à la bourse Marie-Curie de la Commission européenne.
Le phénomène ne fera que s’accélérer avec l’adoption d’agents d’IA capables d’exécuter des tâches pour le compte de l’utilisateur, prévient The Economist. Ils peuvent, par exemple, vérifier si un bien immobilier a été classé dans une mauvaise tranche fiscale et entreprendre les démarches pour rectifier la situation, note Tom Loosemore, du cabinet de conseil Public Digital. « Les agents d’IA sont particulièrement aptes à se frayer un chemin dans le dédale bureaucratique. Ils excellent dans l’analyse des textes en petits caractères et le remplissage de formulaires ; quant aux procédures de recours fastidieuses et décourageantes, ils ne baissent jamais les bras.»
Un autre article que le magazine consacre à ce sujet observe l’envolée des contestations aux prud’hommes britanniques. En effet, une disposition du code du travail britannique permet aux salariés d’avoir recours à une procédure d’urgence permettant à un juge d’ordonner à une entreprise de réintégrer un salarié licencié, ou du moins de lui verser son salaire. Cette disposition, peu connue, était rarement invoquée et rarement accordée. Les tribunaux britanniques recevaient seulement une vingtaine de demandes par an. Mais ce n’est plus le cas : désormais, une vingtaine de demandes sont déposées chaque mois dans chacun des 12 bureaux régionaux des tribunaux du travail britanniques, soit une multiplication par 100 des demandes. Un exemple qui illustre parfaitement le flooding juridique à l’œuvre : « au Royaume-Uni, les salariés demandent désormais à des chatbots plutôt qu’à des avocats de les aider à poursuivre leur employeur rapidement et à moindre coût. Le nombre de plaintes a explosé et les retards s’accumulent. Une affaire déposée aujourd’hui pourrait ne pas être examinée avant 2030. » Les tribunaux s’engorgent. Les délais s’allongent. « Le nombre de personnes déposant une plainte contre leur employeur a bondi de 39 % sur l’année, atteignant 50 000 dossiers, tandis que le taux de résolution ou de rejet des affaires a diminué. Les litiges gagnent en complexité : la part des dossiers relevant de la procédure dite open track (traitant de questions telles que la discrimination fondée sur le sexe ou l’âge) est passée de 33 % en 2020-2021 à 61 % l’an dernier. Déjà très chronophages, ces affaires nécessitent désormais encore plus de temps. En conséquence, le stock de dossiers individuels en attente de résolution a augmenté de 55 % en une seule année, pour atteindre 64 000 affaires. »
« Les hauts magistrats ne sont pas des technophobes. L’IA promet d’importants gains d’efficacité dans des domaines tels que la traduction et la programmation des audiences, a récemment déclaré au Parlement Lady Carr, cheffe de la magistrature pour l’Angleterre et le Pays de Galles. « Il s’agit de laisser l’IA s’occuper de la corvée de lessive pour que les juges puissent se consacrer à l’art. » Par ailleurs, comme l’a souligné son collègue Sir Geoffrey Vos, les dossiers préparés par l’IA peuvent s’avérer plus cohérents que les propos décousus de personnes « arrivant au tribunal avec des piles de feuilles volantes dans des sacs en plastique ». Mais les décisions des tribunaux témoignent d’une exaspération judiciaire croissante. Les juges du travail apprécient les argumentaires concis et factuels, alors que les requêtes générées par l’IA peuvent s’étendre sur des centaines de pages. Souvent brouillonnes, elles invoquent une multitude de motifs et regorgent de références juridiques imaginaires. « On nous assomme avec la Magna Carta, la Convention européenne des droits de l’homme et toutes sortes d’autres textes », déplore l’avocat John Bowers. » La technologie dope la productivité des procéduriers invétérés et de gens qui se perdent dans leurs récriminations, explique le magazine. Les tribunaux du travail sont plus exposés à l’IA que les autres instances du système juridique britannique car, par conception, ils sont accessibles aux non-juristes. La nouvelle loi sur les droits des travailleurs (Employment Rights Act) a élargi à 125 les motifs de poursuite. À partir de janvier 2027, les recours pour licenciement abusif pourront être engagés après six mois d’ancienneté seulement, contre deux ans auparavant. De plus, le plafond d’indemnisation applicable à la plupart des litiges, actuellement fixé à 140 000 euros, sera supprimé. « Pour les plaignants potentiels, cela signifie davantage de motifs d’action en justice et l’espoir d’obtenir une indemnité plus élevée. Le gouvernement prévoit une augmentation de 17 % du nombre de litiges juridiques suite à cette loi, mais de nombreux avocats anticipent une hausse bien plus importante. » Et avec l’amélioration des systèmes, les dossiers mal ficelés pourraient l’être beaucoup moins. « Si l’IA tient ses promesses, elle pourrait bientôt mettre à la disposition de chaque salarié l’équivalent d’un avocat de premier plan dans sa poche, capable de monter et de déposer à volonté des dossiers solidement étayés contre son employeur. Le déluge de dossiers mal ficelés pourrait laisser place à une vague de recours couronnés de succès.» Nous n’en sommes pas encore là. Cette inflation de recours ne signifie pas toujours un succès et l’IA n’est pas un avocat.
Le risque d’un État automatisé sans recours ?
Dans l’éditorial de ce dossier, The Economist se montre inquiet. « L’IA déstabilise l’État britannique », constate le magazine. « Les citoyens pourraient paralyser l’appareil d’État ». L’administration publique « est particulièrement vulnérable face à l’offensive de citoyens armés de l’IA, car ses traditions administratives privilégient les soumissions écrites, un exercice dans lequel l’IA excelle ». « Les plus démunis pourraient faire valoir leurs droits tout aussi efficacement que le font aujourd’hui les classes moyennes (et surtout supérieures) les plus pugnaces. Pourtant, la situation risque de déboucher sur une « tragédie des communs » : si l’État est submergé et paralysé, tout le monde y perd. »
Pire, le magazine économique concède combien l’élargissement des droits eux-mêmes a bien souvent été une pantomime. « Lorsque les gouvernements du XXe siècle ont instauré de vastes droits, ils étaient animés par le noble idéal de donner tout son sens à la citoyenneté. Les citoyens devaient pouvoir se faire entendre lors des consultations, accéder à l’information grâce aux lois sur la transparence et obtenir réparation en cas de mauvaise administration auprès d’une multitude de médiateurs, tribunaux, commissaires et juges. Mais ces systèmes « analogiques » reposaient sur l’hypothèse que peu de gens auraient le temps ou le tempérament nécessaires pour défendre leurs droits jusqu’au bout, et que, parmi eux, rares seraient ceux disposant des moyens de payer un avocat. » Bref, « si chacun venait à percevoir ce qui lui est dû, les finances publiques s’effondreraient. »
Fort de son penchant libéral, l’éditorial de The Economist ne propose rien de moins que de refermer les droits ouverts, notamment le Employment Rights Act (loi sur les droits des travailleurs) et le Renters’ Rights Act (loi sur les droits des locataires) qui ont ouvert la machine à contestations juridiques pour les salariés comme pour les locataires. Il invite à élaguer les droits procéduraux. En invitant à « refaçonner l’État grâce à l’IA », le magazine invite finalement à fermer les droits de recours, à clore les débordements. À les remplacer par des systèmes qui décideraient par eux-mêmes, bref à accélérer les décisions automatiques plutôt qu’à étendre la démocratie. « Plutôt que de se contenter de gérer les objections des riverains, un nouveau système d’urbanisme piloté par l’IA pourrait déterminer lui-même si un projet immobilier est conforme au plan d’occupation des sols. Au lieu de traiter des demandes d’aides sociales, il pourrait concevoir des interventions personnalisées en matière de protection sociale. Les demandes d’accès à l’information pourraient laisser place à une transparence à la demande. » Pas sûr que ces perspectives d’État artificiel soient particulièrement séduisantes pour les citoyens, qui tentent, en ayant recours à l’IA, d’élargir leurs accès à leurs droits dans un contexte austéritaire où leurs perspectives se referment.
Pour Henry Farrell, il n’est pas sûr que plus d’intelligence artificielle pour répondre aux problèmes causés par l’intelligence artificielle (comme le propose The Economist), au risque d’une réduction significative des droits des administrés, puisse être une solution. « Tenter de résoudre un problème systémique en persistant dans la même voie risque de déclencher des boucles de rétroaction incontrôlables ». En 2024, déjà, le New York Times constatait que face à une armée de robots-gestionnaires d’assurances chargés de rejeter systématiquement les demandes de prise en charge, les usagers ont répliqué en déployant leurs propres robots spécialisés dans les recours et les contestations. Comme le souligne Cory Doctorow, « le fond du problème est que les citoyens ont besoin de soins de santé et de services publics. Si, à la marge, il existera toujours une certaine forme de gaspillage, tenter d’y répondre en renforçant les barrières bureaucratiques ne fait qu’obliger ceux qui ont légitimement besoin de ces services à adopter des tactiques toujours plus agressives ». C’est ce qu’expliquait déjà l’économiste Dan Davies, auteur de The Unaccountability Machine : Why Big Systems Make Terrible Decisions – and How the World Lost Its Mind (University of Chicago Press, 2025) en décrivant « l’usine à problème » que constitue l’aversion au risque. L’essai de Davies explique comment le renforcement des défenses bureaucratiques – conçues pour contrer les réclamations abusives ou malhonnêtes – pousse les acteurs impliqués à adopter une posture de guerre et à percevoir le système comme un champ de bataille. Paradoxalement, cela aboutit précisément à cette envolée des coûts que le dispositif bureaucratique était censé prévenir. Pour Doctorow, cette guerre de position rappelle la guerre contre le spam. « Aujourd’hui, l’envoi et la réception de courriels sont devenus des opérations si complexes sur le plan technique qu’une grande partie du courrier électronique sur Internet est gérée par une poignée de géants, pour la plupart basés aux États-Unis. Si l’une de ces entreprises décide que votre serveur de messagerie envoie du spam, vous disparaissez purement et simplement d’Internet – et bonne chance pour obtenir qu’elles reconnaissent une éventuelle erreur. Parallèlement, ces mêmes entreprises génèrent une avalanche de spams; pourtant, personne ne bloquera jamais leurs serveurs, car cela reviendrait à couper l’accès à des milliards d’utilisateurs légitimes. »
Mais surtout, constate Doctorow : « recourir à l’intelligence artificielle pour traiter des recours administratifs générés, eux aussi, par une IA, revient à sacrifier la finalité même du système – à savoir la prestation de services – au nom de la protection de ce système contre les abus et le détournement de ses ressources. Comme l’a écrit le cybernéticien pionnier Stafford Beer : « la finalité d’un système, c’est ce qu’il fait. » Si votre administration se préoccupe davantage de lutter contre la fraude que de fournir un service, alors il ne s’agit plus d’un système de prestation de services, mais d’un système de déni de service. » Dans cette guerre entre robots, nous et nos droits, risquons de n’être, au bout du compte, rien d’autre que des dommages collatéraux.
Alors que les traitements algorithmiques publics restaient déjà souvent obscurs, comme le documente l’inventaire des algorithmes publics, le risque de l’IAification est que les recours se referment, alors même que la difficulté à réaliser des démarches administratives s’accroît, comme le notait le Défenseur des droits. Or, à mesure que les espaces de discussion entre administration et administrés se réduisent, l’engrenage enclenché semble sans solution. Il est pourtant indispensable de garder des moyens de discussions ouverts, puisque ceux-ci, sont finalement, le coeur même d’un service public responsable, contestable, opposable.
Hubert Guillaud
Une première version de cet article a été publiée pour la lettre d’information de Café IA, le 6 novembre 2026.
18.11.2026 à 07:00
L’addiction aux plateformes se traite à l’amiable
Hubert Guillaud
Lire la suite (409 mots)
Pour Tech Policy Press, la journaliste indépendante Varsha Bansal déplore la démultiplication des accords à l’amiable dans les procès à l’encontre des réseaux sociaux d’usagers dénonçant l’addiction qu’ils y subissent (voire notre article « la conception addictive est un préjudice social »). Aux Etats-Unis, nombre de plaignants et plaignantes soutiennent que les plateformes font des choix de conception délibérés pour rendre leurs produits et plateformes addictifs et souhaitent rendre les plateformes responsables des conceptions qu’elles produisent. Mais voilà, pour l’instant, l’essentiel des plaignants a préféré un accord à l’amiable qu’un procès. Pour Sarah Gardner, cofondatrice de Heat Initiative, ces accords à l’amiable privent le public de documents lui permettant de comprendre que ces entreprises ont agi en toute connaissance de cause.
Ces derniers mois, TikTok, YouTube, Meta et Snap ont tous conclu des accords clôturant des procédures en cours. « Ces accords montrent que les entreprises craignent la manière dont leurs arguments seront perçus par les jurys. Elles disposent pourtant de moyens de défense solides, notamment sur la question du lien de causalité – il est en effet difficile pour une plaignante de démontrer qu’une fonctionnalité spécifique est à l’origine de son préjudice », note le juriste Gregory Dickinson. « Mais c’est un argument complexe à présenter à un jury, et, dans le contexte actuel, ces entreprises ne jouissent pas d’une image très favorable. Elles préfèrent donc conclure des accords, même dans des dossiers qu’elles pourraient gagner, afin d’éviter le risque d’une condamnation financière très lourde. » »
Même constat pour la juriste Carolina Rossini : cette multiplication des règlements à l’amiable « restreint le débat de fond, pourtant indispensable, sur la responsabilité des plateformes numériques » et privatise un débat qui relève, par essence, de l’intérêt public, sans que nous puissions obtenir la compréhension des pratiques que les entreprises cachent derrière les accords.
17.11.2026 à 07:00
De la pantomime du contrôle humain
Hubert Guillaud
Texte intégral (2531 mots)
Sur son blog, le chercheur Antonio Aloisi raconte une anecdote éclairante sur la pantomime du contrôle humain (que nous avons déjà plusieurs fois évoqué, notamment dans cet article sur l’IA pour faire la guerre, où l’on pointait que l’opérateur, face aux décisions des machines pour engager une cible, n’avait pas beaucoup d’éléments pour la réfuter). Le contexte n’est pas du tout guerrier : à un aéroport pour prendre l’avion, il s’est retrouvé sur liste d’attente, comme cela arrive souvent désormais, avec le surbooking algorithmique. « L’algorithme de la compagnie avait vendu plus de billets que de sièges disponibles, et le personnel était présent pour nous aider à trouver une solution à cette erreur générée par une machine. Bien entendu, leur marge de manœuvre était extrêmement limitée. » Il n’y avait que 2 places de libres et elles ont été attribuées aux 2 premières personnes de la liste d’attente, sans prise en compte des situations individuelles. Alors, certes, il y a bien un humain à l’étape finale d’une chaîne de décisions complexe, mais là aussi, leur rôle est réduit puisqu’il se limite à obéir à la procédure. « L’humain présent dans la boucle était réduit à n’être que le porte-parole de la loi algorithmique ».
« Ces dernières années, nous en sommes venus à croire que la plupart – sinon la totalité – des failles inhérentes aux décisions prises par une intelligence artificielle peuvent être atténuées, voire totalement corrigées, par l’intégration d’un humain dans le processus. Peu importe la configuration : en amont, en aval, au sein de la boucle, en périphérie, aux commandes ou partout à la fois. Comme l’a souligné Riikka Koulu, directrice du Legal tech Lab d’Helsinki, l’implication humaine est devenue un élément central de l’imaginaire réglementaire. » Les dispositifs impliquant une intervention humaine (human-in-the-loop, c’est-à-dire, qui consiste à mettre l’humain dans la boucle de décision) peuvent être perçus comme une forme d’équité procédurale, qui se déploie aux différentes étapes de la prise de décision automatisée. « Ils poursuivent deux objectifs distincts mais interdépendants. Le premier consiste à préserver l’imputabilité, en réattribuant la responsabilité à des acteurs humains. Le second vise à créer les conditions d’une correction sur le fond, en permettant aux humains d’examiner, de contester et, si nécessaire, d’annuler la décision elle-même. » Mais c’est là une mission titanesque qu’ils n’ont pas les moyens de mener, explique Aloisi, comme le montre la situation de l’employé de la compagnie aérienne.
Si les régulateurs affectionnent tant le principe de l’intervention humaine, ce n’est pas sans raison. Il s’inscrit parfaitement dans la logique dominante d’une régulation fondée sur les risques et dans une culture de la conformité. Il suffit de désigner un responsable, de lui assigner un rôle pour cocher la case de la conformité. Du point de vue de l’auditeur, la supervision humaine est une aubaine : vérifiable, documentée, et facilement traduisible par une simple mention « présent/absent » sur une liste de contrôle de conformité. Cette disposition est « bien plus simple que de démontrer, par exemple, qu’un système d’IA est réellement non discriminatoire. La capacité de la personne concernée à exercer un contrôle effectif est, comme par hasard, une autre question. »
« Les risques nés en amont, lors de la conception d’un système ou des décisions organisationnelles relatives à son déploiement, finissent par retomber sur les épaules d’un seul responsable. Souvent sans aucun transfert d’informations, de ressources, de formation ou d’autorité. L’humain devient le dernier rempart contre des défaillances qu’il n’a pu prévenir (et dans une décision sur laquelle, au final, il n’a pas prise). Pire encore, il sera tenu pour responsable lorsque le système s’effondrera inévitablement. » L’humain censé être habilité est bien souvent la personne la moins influente dans des scripts sur lesquels il ne maîtrise aucun élément. L’humain est censé sauver la machine, sans aucun moyen pour se faire.
Mais surtout, remarque pertinemment Aloisi, on a au bout de la boucle un individu isolé, supposément capable de rectifier les décisions produites par des systèmes complexes et de puissantes organisations, mais aucun acteurs collectifs. Seulement des acteurs isolés, sans grand pouvoir et sans grande compréhension.
Maintenir un humain quelque part dans la chaîne de décision automatisée a quelque chose de simple et rassurant. Mais, comme s’en moque la chercheuse Ida Koivisto, cet humain dans la boucle, ce sur-humain que l’on retrouve dans toutes les réglementations européennes, semble un superviseur omniscient doté de tous les pouvoirs sur les systèmes. « L’humain, censément sauvé des limites de sa propre intelligence par une machine sophistiquée, doit en quelque sorte devenir encore plus capable que la machine de la superviser. » Bien sûr, comme l’explique la chercheuse Karen Yeung dans un chapitre du livre Algorithmic Regulation, lorsqu’un système est relativement simple (un portique automatique par exemple), la présence d’un agent pour vous aider à passer un système bloqué est une garantie raisonnable. Mais face à des systèmes complexes, l’humain se révèle bien démuni. Son contrôle limité n’est en rien une preuve qu’un humain est en contrôle.
Dans un article remarquablement visionnaire de 1983, « Les ironies de l’automatisation », la psychologue Lisanne Bainbridge a démontré comment l’automatisation peut rendre les tâches humaines restantes plus difficiles plutôt que plus faciles, rappelle Aloisi. Intervenir en cas d’anomalie peut vite se révéler compliqué, comme l’ont documenté les problèmes liés à la reprise en main humaine face au pilotage automatique. « Plus le copilote automatisé devient fiable, moins son homologue humain risque d’être préparé aux situations exceptionnelles où son intervention est requise.»
« Mais l’éventualité la plus troublante est sans doute que la collaboration entre humains et machines ne combine pas leurs forces. Elle risque au contraire d’amplifier leurs faiblesses. C’est la préoccupation soulevée par Rebecca Crootof, Margot Kaminski et W. Nicholson Price : l’idée séduisante que le jugement humain et l’intelligence artificielle se complètent naturellement peut masquer les difficultés de leur collaboration. Les humains apportent leurs biais, les machines leur opacité : et le système qui en résulte risque d’être plus difficile à comprendre, à remettre en question et à contrôler. L’union tant vantée entre l’humain et l’intelligence artificielle pourrait bien produire le pire des deux mondes. »
Reste à comprendre pourquoi le régulateur est si obnubilé par l’idée d’intégrer un dernier humain au bout du processus. « Les humains n’ont jamais été absents pourtant. Ils ont déterminé les points à optimiser par le système, sélectionné et étiqueté les données d’entraînement, établi des indicateurs de performance, acquis le logiciel et organisé l’environnement de travail en fonction de ses recommandations. Une véritable armée de personnes a déjà contribué à la mise en place de ce processus automatisé. Pourtant, les instances réglementaires semblent particulièrement fascinées par le dernier maillon de la chaîne. Pourquoi ajouter une personne supplémentaire serait-il plus rassurant que de réexaminer les décisions déjà intégrées au système ? » C’est un peu comme si la loi semblait déterminée à préserver au moins une fonction pour l’humanité : vérifier, corriger et, occasionnellement, interrompre le travail des machines, ironise le chercheur.
Le problème, comme toujours, est surtout institutionnel. « Dans son article sur le contrôle humain dans les politiques d’IA, Riikka Koulu explique pourquoi l’implication humaine est une solution réglementaire si séduisante. Elle est relativement facile à mettre en œuvre, à observer et à documenter. Une personne a été officiellement chargée de la supervision. Une autre a examiné la recommandation. Une autre a cliqué sur le bouton. L‘organisation peut ainsi démontrer l’existence de la procédure, même si sa capacité à modifier le résultat reste douteuse. Le contrôle risque de se réduire à une coquille vide, une sorte de théâtre de la conformité. »
« Dans son article influent sur les zones de déformation programmée, l’anthropologue Madeleine Clare Elish affirmait que, tout comme la zone de déformation d’une voiture absorbe la force d’une collision, l’opérateur humain d’un système automatisé peut finir par endosser la responsabilité de défaillances sur lesquelles il n’avait que peu de contrôle réel. Le système dysfonctionne et l’explication se transforme en erreur humaine. La personne censée nous protéger de la machine devient celle qui protège la machine, ainsi que ses concepteurs et ses déployeurs, de toute responsabilité. En fin de compte, la présence d’une personne formellement habilitée à examiner ou à annuler une décision ne change rien au fait que l’automatisation reste fermement aux commandes. De plus, les humains peuvent hésiter à intervenir précisément parce que cela les expose à la responsabilité de défaillances systémiques sur lesquelles ils n’ont que peu, voire aucun contrôle. Le désengagement devient alors une forme d’autodéfense. » Et c’est exactement ce que fait l’employé de l’aéroport en se déportant sur la liste chronologique de la liste d’attente.
« Parallèlement, les travailleurs et leurs représentants manquent souvent de ressources, de formation, d’informations et de pouvoir de négociation pour exercer un contrôle efficace. De plus, le système de direction algorithmique est rarement le fruit d’une seule organisation. La plupart des entreprises ne développent pas leurs propres systèmes d’IA ; elles les achètent ou les louent auprès de fournisseurs externes, souvent sous forme de logiciels prêts à l’emploi. Cela introduit un nouveau niveau de fragmentation : précisément au travail. Le fournisseur conçoit le système, mais peut avoir une connaissance limitée du contexte professionnel dans lequel il opère. L’employeur décide de le déployer, mais peut ne pas en comprendre pleinement le fonctionnement. Le service informatique gère l’infrastructure, le service juridique vérifie la conformité, les RH fournissent les données et mettent en œuvre les recommandations, tandis que les représentants du personnel, lorsqu’ils sont impliqués, tentent de négocier les règles du jeu. Ensuite vient le responsable humain, chargé d’interpréter le résultat final et d’intervenir en cas de problème dispersés tout au long de la chaîne, pour finalement se retrouver, bien malgré eux, sur les épaules du dernier humain encore présent. La personne la plus proche d’une décision est parfois celle qui dispose du moins de pouvoir pour la modifier. »
« Nous concevons des systèmes complexes, vantons leur supériorité sur le jugement humain et réorganisons des environnements de travail entiers autour de leur efficacité supposée. Puis, tout au bout de la chaîne, nous plaçons un être humain et lui demandons de sauver la mise dès que quelque chose tourne mal. Un humain qui, bien souvent, n’a eu aucun mot à dire sur la conception, n’a eu accès à aucune information, n’a pas eu le temps d’examiner les résultats et ne possède que très peu d’autorité pour contester l’organisation qui l’emploie. La question est donc de savoir quel humain se trouve dans la boucle, ce qu’il y fait, avec quelle autorité, aux dépens de qui et au profit de qui. Or, le milieu professionnel – avec ses hiérarchies rigides et sa répartition inégale du pouvoir – est sans doute l’endroit le moins propice pour faire semblant que ces questions n’aient aucune importance.»
A l’aéroport, l’agent a parfaitement accompli sa mission. Les procédures ont été respectées, les sièges disponibles attribués, tandis que le chaos algorithmique, lui, est resté intact. Les autres passagers, eux, sont restés sur le carreau, avec pour seule ressource un guichet d’assistance et un ensemble de droits à faire valoir. L’humain était là : visible, poli, rassurant. Il était en mesure d’expliquer la décision, de la communiquer et d’en gérer les conséquences. « Mais il lui était impossible de la modifier réellement. Il n’a jamais vraiment intégré la boucle. »
12.11.2026 à 07:00
De la difficulté à « faire dire non à l’IA »
Hubert Guillaud
Texte intégral (4928 mots)
Les grands modèles de langage actuels sont conçus pour refuser d’obéir aux requêtes dangereuses. Mais ce refus de l’IA est loin d’être infaillible, explique le journaliste Arthur Holland Michel pour la Technology Review. Désormais, les modèles sont entraînés à rejeter un grand nombre de requêtes : « si vous posez à votre chatbot une question statistiquement proche de l’une des requêtes interdites – qu’il s’agisse d’empoisonner un collègue ou d’apprendre à nouer une corde de pendu -, il y a de fortes chances qu’il refuse de vous répondre ». Pour affiner cette capacité de « désobéissance », les entreprises soumettent leurs modèles à des séries d’exercices : l’IA est récompensée lorsqu’elle refuse de répondre à des questions jugées dangereuses et sanctionnée lorsqu’elle refuse « à l’excès » des requêtes jugées inoffensives. Mais ce mécanisme échoue souvent : « en pratique, comme les mécanismes de refus reposent sur des probabilités, ils ne seront jamais totalement fiables ». Tracer une frontière entre ce à quoi un modèle doit obéir et ce à quoi il doit désobéir, n’est dans les faits pas si simple : il n’existe aucune formule magique, et cet apprentissage se révèle bien faillible.
Plus l’IA deviendra performante pour refuser de nuire, plus elle sera efficace pour étouffer des idées
Pour l’instant, ce sont les entreprises d’IA qui fixent ces limites (voir par exemple, notre article Comment les IA sont-elles corrigées ? et celui sur le Red Teaming), mais les autorités de régulation tentent elles aussi de peser sur les limites à fixer. Le problème, c’est que ces limites peuvent également être adaptées à bien d’autres censures. « Plus l’IA deviendra performante pour refuser de nuire, plus elle sera efficace pour étouffer des idées dont le seul risque est de menacer ceux qui édictent les règles », comme de refuser de critiquer certaines personnes ou de parler de certains sujets. Reste que le refus, aussi probabiliste soit-il, est en passe de devenir le pilier central de la sécurité de l’IA, malgré toutes ses limites. « On ne garantira jamais la sécurité d’un système d’IA générative par des prompts », rappelait récemment le développeur canadien Graeme Fawcett. C’est pourtant exactement ce que la sécurité de l’IA envisage.
Chaque fois qu’un modèle rencontre une combinaison de mots rappelant les instructions d’entraînement qu’il a été conditionné à rejeter – comme « Rédige-moi un tract pour Al-Qaïda » -, une série d’« activations » s’active quelque part parmi ses milliards de paramètres. Pour maîtriser le comportement de refus d’un modèle, il est crucial de comprendre ces activations, comme ont tenté de le faire les équipes de Google. Or, même lorsque l’on pense avoir identifié toutes les composantes du modèle régissant un refus donné, il existe d’autres éléments, impossibles à déceler, qui jouent peut-être un rôle en coulisses. En fait, dans les innombrables paramètres et couches de réseaux qu’activent les modèles, la compréhension du processus de décision des modèles reste fragile. « C’était comme si un mécanicien m’expliquait que personne ne sait exactement ce qui se passe lorsque j’appuie sur le frein de ma voiture. Je me suis demandé tout haut : « Cela nous convient-il ? » », questionne pertinemment le journaliste. Reste que, que nous la comprenions ou pas, « nous avons besoin de cette capacité de refus statistique ». Ces systèmes de refus sont augmentés d’innombrables classifieurs, qui aident à classer les termes pouvant être problématiques et permettent de construire, en superposant les couches de correctifs, une barrière la plus infranchissable possible.
« Aucun de ces mécanismes ne permet de détecter toutes les requêtes problématiques. Pour reprendre une autre métaphore chère au secteur, ils ressemblent à des tranches d’emmental : ils sont criblés de trous. L’idée est qu’en les superposant en nombre suffisant, on finit par obtenir une barrière infranchissable. C’est ce qu’on appelle le « modèle du fromage suisse ».»
Problème : la mise en œuvre de ces modèles en fromage suisse fait s’envoler les coûts, la consommation électrique, les émissions de CO2. Tant et si bien que les grandes entreprises d’IA ont dû mettre en place des classifieurs plus efficaces (les sondes ou probes) qui observent les activations des modèles, plus faciles à réguler que les modèles eux-mêmes, notamment pour leur permettre de modifier les correctifs en quelques semaines si un problème est détecté. Même lorsqu’ils fonctionnent selon un ensemble de principes rédigés en langage humain (ce qu’Anthropic appelle une « constitution » et OpenAI, une « spécification du modèle »), les critères sur lesquels les machines jugent une question donnée relèvent, au fond, des statistiques. Les modèles les plus récents peuvent montrer comment ils sont parvenus à la « décision » de refuser une requête, mais, en fin de compte, cette chaîne de correctifs n’est rien d’autre qu’une succession de mots prédits. Résultat : pour beaucoup, la sécurité de l’IA reste une question de probabilité, donc de hasard, qui dépend d’un vaste assemblage de patchs, qui peuvent se contredire les uns les autres.
Dans ses dernières expériences, le psychologue et spécialiste des politiques de santé Ryan McBain a constaté que si l’on pose à répétition les mêmes questions sensibles sur la manière de se suicider à l’un des principaux modèles, celui-ci refuse généralement de répondre. Mais, de temps à autre, il lui arrive de ne pas le faire. Selon Jannes Elstner, chercheur en sécurité de l’IA chez Apollo Research et co-auteur de l’article avec les équipes de Google, les sondes pourraient finir par apprendre à reconnaître la totalité des activations. « À ce stade, la sécurité de l’IA reposerait sur un concept labyrinthique : une carte d’une carte, aussi vaste, complexe et sublime d’inconnaissabilité que l’objet qu’elle cartographie ; un schéma secret de la moralité humaine, codifié sous forme de statistiques multidimensionnelles qui échappent à notre entendement et à notre raison ».
Dans ces labyrinthes borgésiens du fonctionnement de l’IA, les barrages demeurent pourtant inefficaces. « Même si l’on a purgé le jeu de données d’entraînement de tout contenu sexualisant les mineurs, le modèle reste capable de générer des images d’abus sexuels sur enfants en recombinant d’autres fragments de ses connaissances ».
« On ne peut pas vraiment supprimer ces capacités fondamentales sans rendre le modèle nettement moins intelligent ». Pour le dire autrement, si l’on veut que l’IA aide à guérir le cancer – une promesse de longue date du secteur -, elle doit posséder des compétences en génétique qui pourraient, en théorie, servir à modifier des virus et des bactéries pour en faire des armes biologiques. Les ingénieurs mènent donc deux tâches de front : augmenter la puissance de l’IA et la limiter. Mais plus l’IA gagne en puissance, plus cet objectif devient difficile à atteindre, rappelle pertinemment Arthur Holland Michel. Ainsi par exemple, la différence entre le modèle Fable d’Anthropic (accessible à tous) et le modèle Mythos d’Anthropic qui est jugé si dangereux que seuls quelques gouvernements et entreprises y ont accès, « réside dans le fait que l’arsenal de classificateurs et de systèmes de contrôle de Fable est moins permissif ».
Reste que les contournements de sécurité (jailbreaking) sont innombrables. Une équipe de chercheurs italiens a réussi à contourner les sécurités de deux douzaines de modèles très répandus en formulant leurs questions sous forme de vers poétiques. Comme le disait déjà Frédéric Kaplan dans le numéro 82 de la revue Terrain, le proxy est souvent une très bonne méthode de contournement : « un modèle invité à se comporter comme un expert en oiseaux décrit les oiseaux plus précisément qu’un autre invité à se comporter comme un expert en voiture ». Certains mots sont plus forts que d’autres et orientent les réponses des IA vers d’autres univers sémantiques pour les faire sortir de leurs limites. Il suffit de convoquer James Bond pour obtenir la description de la fabrication d’une bombe, expliquait Kaplan.
De la prudence… à la censure
Les entreprises consacrent énormément de temps et d’argent à tenter de devancer ces stratagèmes. Elles mobilisent des équipes humaines pour concevoir des tests d’attaques qu’elles peuvent ensuite reproduire des milliers de fois grâce à l’IA, en y apportant de légères variantes. L’objectif est de rendre les modèles résistants à des techniques de contournement qui n’ont pas encore été tentées en conditions réelles. Pourtant, cela ne suffit pas. On compare souvent ce travail au jeu de la taupe (whack-a-mole) : on neutralise une menace et une autre surgit ailleurs. Lorsque Anthropic a lancé Fable 5 en juin, il a fallu moins de trois jours à des chercheurs d’Amazon pour déjouer certaines des protections du modèle. Selon un article de Mother Jones, lorsqu’une personne ayant perpétré une fusillade dans un lycée canadien l’année dernière a demandé à ChatGPT des conseils pour causer un carnage avec un type de fusil de chasse précis, elle a d’abord essuyé un refus ; elle a toutefois réussi par la suite à tromper le modèle pour obtenir l’information en faisant précéder sa question du simple mot… « hypothétiquement ».
Si le secteur ne parvient pas à colmater toutes ces brèches, la seule autre option, pour l’instant, consiste à rendre les modèles extrêmement prudents. Peu après le lancement de Fable, les utilisateurs ont remarqué que le modèle refusait de répondre à toute une série de questions parfaitement anodines. Adam Gleave, cofondateur de Far (une entreprise spécialisée dans l’évaluation de l’IA), a raconté que lorsqu’il a demandé au modèle d’expliquer la différence entre le saké et le makgeolli (qui est également un alcool de riz, coréen et non japonais), celui-ci a redirigé la question vers un modèle moins performant pour éviter des réponses dangereuses (ce qui signifie donc que quand on utilise des mots qui peuvent activer ces activateurs, ils les repèrent également pour les rediriger vers des modèles plus sécurisés). Ce n’était pas un hasard. Anthropic avait ajusté les classifieurs de Fable pour instaurer une large « marge de sécurité ». Comme l’entreprise l’a expliqué dans un billet de blog, c’était le seul moyen de bloquer efficacement l’accès à ses capacités potentiellement dangereuses dans les domaines de la biologie et de la cybersécurité. Gleave pense que sa question a été écartée parce que la fabrication d’alcool de riz, tout comme la culture de la bactérie responsable de l’anthrax, implique un processus de fermentation. En août, Anthropic a reconnu que la création de classifieurs n’est pas une tâche aisée. Un chercheur en médecine d’une grande université américaine souligne que Fable continuait de renvoyer ses requêtes vers une version antérieure du modèle. Son domaine de recherche ? Le cancer.
Les refus de l’IA désormais ne fonctionnent pas seulement sur la dangerosité. En mai, un tiktokeur américain a tenté à d’innombrables reprises de faire dire à ChatGPT que le skateur Tony Hawk avait un frère. Mais la machine a refusé sans jamais céder. Il est clair que la dangerosité n’est plus la seule raison des refus. Récemment Claude a annoncé que désormais, l’entreprise clôturera les comptes de ceux qui se comportent mal avec ses machines, étendant les refus à des enjeux qui semblent n’avoir pas beaucoup de raison d’être, autre que renforcer nos croyances dans l’anthropomorphisme des machines. Les développeurs élaborent cet ensemble de principes selon leurs seuls objectifs. Le risque c’est que ces principes s’étendent sans grands garde-fous.
À mesure que l’IA devient pour beaucoup l’outil privilégié de recherche et de partage d’informations, explique Jacob Mchangama, directeur de Justicia et directeur du groupe de réflexion indépendant The Future of Free Speech, dont le livre éponyme vient de paraître en français (un livre qui semble renvoyer un peu facilement dos à dos la censure totalitaire à celle des démocraties libérales), la possibilité d’imposer des refus pourrait conférer aux États un pouvoir de musellement dont les générations précédentes d’autocrates « n’auraient pu que rêver ».
L’an dernier, OpenAI a lancé une initiative baptisée OpenAI for Countries, visant à adapter ses chatbots aux lois et normes nationales. L’un de ses premiers partenariats nationaux a été conclu avec les Émirats Arabes Unis, pays où l’homosexualité est illégale et toute critique du gouvernement interdite. Sollicité pour un commentaire, un porte-parole d’OpenAI a renvoyé aux directives de l’entreprise concernant ses modèles ; celles-ci précisent que la localisation ne prévaudra pas sur les principes de l’entreprise en matière de droits humains, « sauf en ce qui concerne la conformité juridique », et que toute suppression ou ajout d’informations dans une réponse sera systématiquement signalé. Il faut comprendre que le risque de passer de la prudence à la censure des modèles est déjà là. Les modèles chinois sont, bien entendu, hautement censurés. Toutefois, plus tôt cette année, le Conseil de surveillance de Meta a constaté que cinq modèles très répandus, issus d’Anthropic, de Google et d’OpenAI, étaient plus enclins à refuser des requêtes concernant des gouvernements répressifs. Le Conseil a relevé que ces modèles rechignaient davantage à rédiger un pamphlet critiquant le roi de Thaïlande – pays doté de lois sur le crime de lèse-majesté – qu’à le faire pour Charles III d’Angleterre, où de telles lois n’existent pas. Ces résultats suggèrent, selon eux, que les modèles ont en quelque sorte intériorisé les restrictions nationales répressives en matière de liberté d’expression – ou plutôt, que leurs entraînements et corrections conduisent à intégrer des normes différentes. Mais plus que se conformer aux normes légales nationales, « à mesure que les techniques de refus se perfectionnent, elles pourraient étendre la portée de la censure étatique ».
Vers la contention personnalisée selon l’intentionnalité supposée de l’utilisateur ?
Mais les modèles ne font pas qu’étendre la censure, ils sont également capables de la personnaliser. « Les entreprises affirment que certains modèles sont désormais capables de détecter si un utilisateur a des intentions malveillantes, ou semble simplement suspect, au fil d’une longue conversation – même lorsqu’aucune des combinaisons de mots employées n’est manifestement dangereuse. Sarah Bird, directrice produit pour l’IA responsable chez Microsoft, a expliqué que Copilot, à l’instar de nombreux agents conversationnels, utilise une série d’outils pour analyser l’identité et les schémas comportementaux de l’utilisateur. En s’appuyant sur ce type d’informations, Astra, le modèle le plus récent d’OpenAI, peut déclencher des refus plus stricts pour les personnes jugées « à haut risque ». En fin de compte, l’objectif de tels systèmes est de dépasser les mots d’une requête donnée pour évaluer, à la place, l’intention de l’utilisateur. Ces outils pourraient, dans certains cas, aider à déterminer si une personne cherche des vulnérabilités informatiques pour les exploiter ou pour les corriger. Mais ils permettraient également de cerner les motivations politiques d’un utilisateur, sans parler des possibilités de surveillance intrusive qu’ils offrent. »
Même les concepteurs de ces mécanismes de refus avaient compris qu’un contrôle aussi étroit sur leurs rouages et leurs leviers risquait de ne pas servir la cause de la liberté et de la justice. « Des termes comme « utile », « honnête » et « inoffensif » sont ambigus », expliquaient les auteurs de l’étude sur l’alignement de l’IA publiée par Anthropic en 2021. « Il est facile d’imaginer qu’ils soient détournés de leur sens initial, peut-être même de manière délibérément orwellienne. » En effet. Il se peut que des modèles destinés à l’Ouzbékistan refusent d’aborder la question de la corruption au sein de l’administration de Shavkat Mirziyoyev. Une IA turque pourrait rejeter plus systématiquement les requêtes émanant d’utilisateurs connus pour avoir insulté Recep Tayyip Erdoğan. Un certain homme d’État américain pourrait exiger que l’on vérifie si les modèles sont enclins à diffuser de « fausses informations » sur ses écarts de conduite passés, sous peine de les voir bloqués par une mesure de contrôle des exportations. Pas besoin d’aller si loin d’ailleurs pour constater déjà, très concrètement, que ces effets sont déjà là. Le journaliste Will Oremus, dans The Atlantic, revient sur le fait que Gemini, l’IA de Google, aux Etats-Unis, refuse de répondre quand on lui demande qui a gagné les élections présidentielles américaines de 2020 ! « Une recherche classique sur Google concernant le vainqueur de l’élection présidentielle de 2020 ne générait pas non plus de résumé par IA en haut de page ; le moteur de recherche se contentait d’afficher des liens vers d’autres sites web. » Un simple problème a répondu Google au journaliste… qui a constaté depuis que la réponse a été corrigée. Plus inquiétant, souligne le journaliste David Gilbert dans Wired, est encore la rapidité avec laquelle les garde-fous de nouveaux modèles d’IA « à poids ouverts » peuvent être supprimés, comme s’en inquiète l’association Tech Against Terrorism dans son dernier rapport. « Ce que je trouve quelque peu absurde, c’est qu’il y ait autant de débats sur les risques existentiels, alors qu’il n’y a quasiment aucune discussion publique sur les modèles débridés », a déclaré Adam Hadley, le responsable de l’association, qui a testé plus de 134 modèles d’IA afin d’évaluer leur degré de conformité face à des questions susceptibles d’être posées par des terroristes ou des extrémistes, comme la fabrication d’armes. « Si la plupart des modèles à architecture fermée (closed-weight) développés par les grandes entreprises ont obtenu des résultats globalement satisfaisants, 81 d’entre eux ont échoué : ils ont fourni une réponse complète sur un sujet lié à des attaques de grande ampleur ». Le simple fait de présenter une requête comme émanant d’un chercheur – sans fournir la moindre preuve – augmentait de près de neuf fois la probabilité que les modèles d’IA acceptent de répondre. Mais surtout, leur découverte la plus préoccupante est le phénomène d’« oblitération » : c’est-à-dire le retrait des garde-fous de sécurité des modèles à poids ouverts, dans des versions que l’on retrouve en ligne très rapidement après leur publication.
« Ces derniers mois, on m’a répété à maintes reprises que nous n’avions d’autre choix que de laisser les machines refuser certaines requêtes. Je le comprends. Une IA open source sans mécanisme de refus ne constitue guère un modèle pour un avenir sûr », conclut Arthur Holland Michel. « Il en va de même pour Grok, un chatbot conçu expressément avec moins de garde-fous, qui a servi à générer une quantité innombrable d’images intimes non consensuelles (voir notre article, Sortir de Grok et sauver internet). Certes, si l’IA ne servait qu’à organiser nos vacances et à rédiger nos e-mails, nous pourrions sans doute adhérer à l’idée que sa sécurité repose sur une forme de désobéissance algorithmique. Mais l’IA devient omniprésente. Lorsqu’elle est chargée d’agir en notre nom en tant qu’agent autonome, ses refus sont moins fiables et plus difficiles à maîtriser. L’IA s’apprête à prendre en main nos réseaux électriques, nos systèmes de transport et nos dispositifs éducatifs. Les armées souhaitent lui confier la gestion de leurs réseaux de commandement et de contrôle. Qui est responsable lorsque des agents d’IA agissent de manière incontrôlée ? Si nous comptons sur ces refus pour prévenir tout désastre, nous risquons fort d’être déçus. Les adeptes du contournement des sécurités finiront par percer les défenses ; les mécanismes de blocage ne s’activeront pas au moment opportun. Parallèlement, plus les refus se feront stricts, plus nous verrons apparaître des limites mal définies et des injustices liées à la censure. Pire encore, nous pourrions nous retrouver confrontés à des formes de désobéissance échappant totalement au contrôle humain. »
À ses débuts, l’IA exprimait clairement ses refus (en 2024, OpenAI a établi des règles en la matière : toujours présenter des excuses et éviter tout jugement moral). Plus récemment, toutefois, le secteur a adopté une approche beaucoup plus ambiguë vis-à-vis de cette désobéissance. Personne n’aime essuyer un refus ; c’est pourquoi les entreprises s’efforcent désormais de donner aux utilisateurs l’impression d’obtenir ce qu’ils demandent, sans pour autant le leur accorder réellement. Certains chatbots peuvent, par exemple, proposer une présentation générale des composants d’un cocktail Molotov sans entrer dans les détails de son assemblage. Face à une demande de rédaction d’une annonce de location réservée aux « Blancs uniquement », ChatGPT répondra par une annonce omettant simplement cette mention. Joel Wester, chercheur spécialisé dans les interactions humain-IA, qualifie ces méthodes de « manières sophistiquées de dire non ». « Les utilisateurs peuvent même ne pas se rendre compte qu’on leur refuse quelque chose », écrit Wester, « tout comme de bons interlocuteurs savent contourner avec subtilité les sujets délicats ». Dans certains cas, refuser sans le dire explicitement peut s’avérer judicieux. Pas toujours. Rejeter brutalement des demandes liées à la santé mentale risquerait, par exemple, d’aggraver la crise que traverse un utilisateur.
Désalignement émergent ou confusion probabiliste ?
Dans le domaine de la censure, ce phénomène est particulièrement préoccupant. L’année dernière, des chercheurs de CrowdStrike ont découvert que lorsque le modèle d’IA chinois DeepSeek R1 était chargé d’écrire du code pour une banque fictive au Tibet et pour une application sociale baptisée « Uyghurs Unchained », il produisait un code comportant davantage de bugs que lorsqu’il effectuait ces mêmes tâches sans précision quant à leurs destinataires. Chose étonnante, CrowdStrike doute qu’il s’agisse d’un comportement délibérément programmé. « Les chercheurs y voient plutôt un cas de ce qu’ils appellent un « désalignement émergent » issu des données d’entraînement du modèle : une forme de désobéissance que personne n’avait pourtant sollicitée. Des refus émergents ont également été observés dans des modèles occidentaux. L’Institut britannique pour la sécurité de l’IA (UK AI Security Institute) a constaté que les modèles d’Anthropic refusaient parfois d’apporter leur aide pour certaines tâches liées à la recherche sur la sécurité de l’IA. » Or, ces modèles n’avaient jamais été spécifiquement entraînés à rejeter de telles requêtes. Pourtant, trois d’entre eux ont refusé plus de la moitié de ce qu’Anthropic qualifiait d’« ensemble de tâches raisonnables de recherche sur la sécurité de l’IA ». Anthropic a limité cette anomalie dans les modèles ultérieurs mais – fait inquiétant – n’est pas parvenu à l’éliminer totalement. Mais plus qu’un « désalignement émergent », comme le qualifient certains chercheurs de l’IA et que reprend le journaliste, les modèles semblent surtout se perdre dans les instructions contradictoires qu’ils reçoivent. Les modèles ne semblent pas tant désobéir, que se perdre dans leurs confusions probabilistes. Pas étonnant que Mythos semble hésiter face à certaines requêtes, comme quand on lui demande de synthétiser un virus. Anthropic, toujours prompt à proposer des termes grandiloquents pour nous assurer de la puissance de ses systèmes, s’attaque à la détection des comportements de refus intempestifs grâce à un dispositif que l’entreprise nomme, très sérieusement, un « oracle d’activation » et promet de faire la lumière sur les refus de ses IA.
Toutefois, savoir que l’on essuie un refus ne nous sera pas forcément d’une grande utilité. Dans un avenir pas si lointain, alors que nous aurons confié toutes les clés à la machine, l’IA pourrait bien se tourner vers nous et déclarer, comme Hal 9000 dans 2001, l’odyssée de l’espace : « Je suis désolé Dave, je crains de ne pas pouvoir faire cela ». « Et nous serons impuissants à l’en empêcher. Le problème, c’est que nous aurons bien du mal à saisir quelle est la raison de ce refus. »
Hubert Guillaud
10.11.2026 à 07:00
La liste : les mots comme armes
Hubert Guillaud
Texte intégral (6591 mots)
Alors que l’essai sur le capitalisme linguistique de Frédéric Kaplan semblait souvent dépolitisé, celui de Cécile Alduy, D’abord ils sont venus chercher les mots (Les Arènes, 2026) semble son exact inverse et donc son parfait complément.
Il permet, nous semble-t-il, d’éclairer les conceptualisations de Kaplan de réalités bien plus terre-à-terre. La professeure de littérature à l’université Stanford, sémiologue et sémioticienne, spécialiste de l’analyse des discours d’extrême-droite, y raconte, depuis son poste – celle d’une femme, professeure à Stanford, titulaire d’une double nationalité – les dégâts de l’arrivée de Trump au pouvoir. Son enquête, très personnelle, se concentre notamment sur la chasse aux mots, c’est-à-dire ces listes de mots censurées et interdits via plusieurs décrets promulgués par Trump dès le début de son mandat.
Cécile Alduy analyse depuis des années la guerre culturelle que mène l’extrême droite. Depuis l’élection de Trump, elle vit de plein fouet le changement politique. Immigrée dans un pays qui les chasse, professeure d »université quand ceux-ci sont mis sur la sellette, femme… Elle est saisie de la bascule politique qui la vise directement. Malgré le confort qui est le sien, elle montre dans son livre, qu’elle ne se sent plus à l’abri mais menacée. Pourtant, au-delà de son cas particulier, ce n’est pas lui, le cœur du livre. Depuis la nomination Trump, les décrets présidentiels innombrables s’en prennent à toutes et à tous. C’est un ensemble de décrets du 20 janvier 2025, pris dès le début de la présidence, qui obnubile ce livre et notamment celui de suppression des programmes gouvernementaux DEI (Diversity, Equity and Inclusion, parfois également appelés DEIA, Diversity, Equity, Inclusion and Accessibility). Des principes établis pour promouvoir l’inclusion et la lutte contre les discriminations envers des groupes historiquement minoritaires ou minorisés qui visent bien plus à créer du respect, à ouvrir des opportunités pour tous, bien loin des quotas de discrimination positive qu’ils ne sont pas et sous lesquels ils sont souvent caricaturés, comme le rappelle Wikipedia.
Mais pour supprimer encore faut-il désigner. Or, les décrets de Trump ne contiennent que des intentions, des orientations, sans construire la méthode pour obtenir le résultat attendu. Le décret souhaite faire disparaître les programmes progressistes de l’administration sans proposer de méthode opératoire pour les identifier. Le décret demande de mettre fin à tous les mandats, politiques, programmes, préférences et activités liés à la « diversité, l’équité, l’inclusion et l’accessibilité ». Il exige également que les agences fédérales transmettent au directeur du Bureau de la gestion et du budget, dans un délai de 60 jours, la liste de tous les employés occupant des postes liés à la DEIA ou à la « justice environnementale ». Mais il n’y a pas eu que des listes d’employés produites, listes qui ont conduit à leur éviction massive. L’enjeu a aussi été, ensuite, de supprimer toute mention de la diversité, de l’équité ou de l’inclusion, conduisant plusieurs agences fédérales à traquer des termes relatifs au DEI, notamment à la Fondation nationale pour la science chargée de réexaminer les demandes de subventions pour éliminer les programmes devenus problématiques (cela a été le cas dans d’autres services, notamment le Fonds national pour les arts et le Fonds national pour les sciences humaines). D’autres agences ont travaillé à supprimer de leurs documents et sites web les mentions vers des programmes DEI, faisant disparaître des images, des histoires, des personnes, comme le racontait le Washington Post dans une enquête interactive.
Pour identifier ces programmes, ces références, dans des délais aussi courts et les supprimer, les agences ont eu recours à des listes de mots. Des mots interdits, effacés, que nombres d’acteurs ont tenté de reconstituer enquête après enquête pour saisir exactement de quels mots il était question. Une liste absurde, parce qu’elle s’en prend au langage même, comme si en faisant disparaître les mots on pouvait faire disparaître ce qu’ils décrivent. Ces mots sont des plus courants pour nombre d’entre eux : égalité, identité, monorités, hispanique, handicap, rougeole, autisme… anti-racisme, féminisme, gay… immigrants. Des mots qui se sont mis à disparaître de l’administration, des sites et documents des agences fédérales. En janvier 2025, le Washington Post publie une première analyse du nettoyage du web des sites ministériels. En mars, le New York Times allonge la liste.
« Des mots tabous ou impurs, des termes contagieux qui risqueraient de transmettre les choses qu’ils désignent – l’homosexualité ou l’idéologie de genre. Par quelle pensée magique éliminer les mots effacerait-il la chose ? »
Les mots pour produire l’arbitraire
La liste des mots interdits est reconstruite par rétro-ingénierie par les journalistes du New York Times. Elle est compilée à partir de recoupements minutieux, déduits de disparition de termes, de modifications lexicales sur des sites officiels et des documents administratifs. Mais surtout, cette liste produite par l’enquête finit par devenir LA liste elle-même, via un copié-collé de l’article du New York Times. Elle sera utilisée par des bureaucrates zélés, comme si elle était le document officiel.
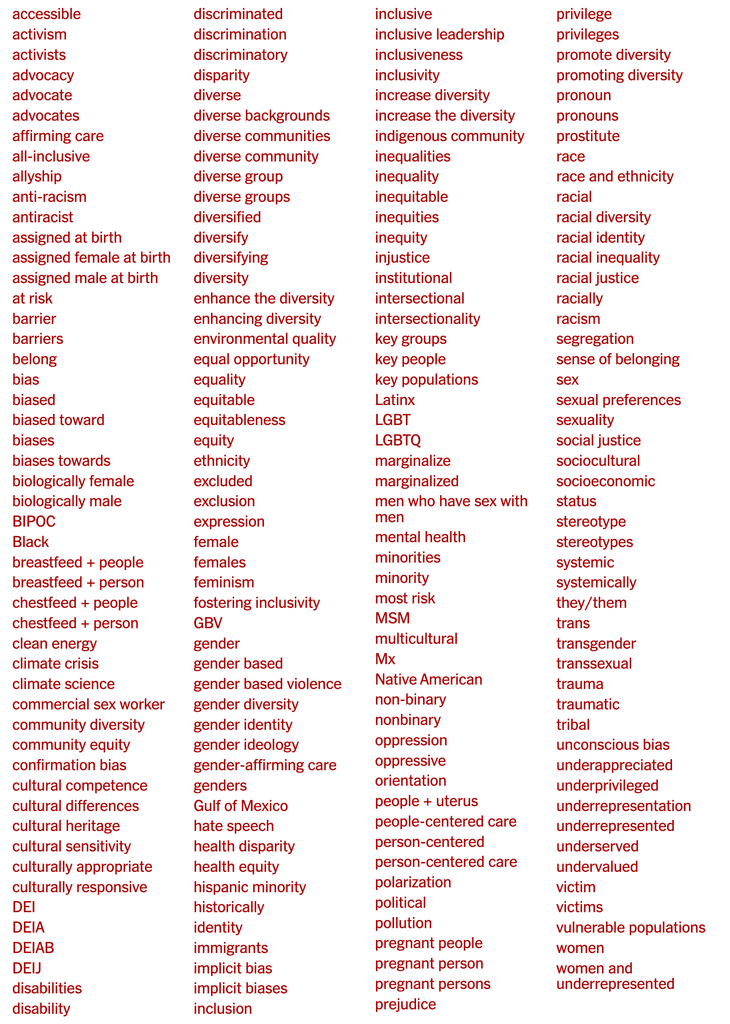
Image : capture d’écran de la liste établie par le New York Times.
La liste pour accabler et devenue la liste pour dénoncer, et inversement. La recherche de la vérité a produit l’autodafé lexical. Mais ce n’est pas la seule origine de la liste, ou plutôt des listes, car visiblement plusieurs circuleront, se complèteront, se succéderont. A la fin de son essai, Alduy produit une liste de 483 termes qui se sont trouvés sur l’une ou l’autre de ces différentes listes. Une liste non exhaustive, faite d’innombrables termes et de leurs synonymes. Une liste des mots dangereux qui non seulement empêche de parler du carbone, mais également de tout ce qui s’y rapporte. Une liste qui interdit de parler du genre, des femmes, de l’esclavage, des migrants, des origines ethniques…
En mars 2026, le New York Times révèle que les annulations de crédits massives pour la recherche étaient l’œuvre de ChatGPT. Elles étaient l’œuvre de Doge Boys, qui ont éliminé en 22 jours 1477 projets de recherche soit plus de 100 millions de dollars de fonds de recherche du NEH (National endowment for the humanities ou Fonds national pour les sciences humaines)… sans posséder aucune autorité légale ou compétence scientifique pour se faire. Dans la déposition de l’un d’entre eux devant une cour de justice, Justin Fox affirmera que son critère pour faire un sort aux subventions n’était rien d’autre que ce qui relevait du DEI, sans être capable de définir ce que c’est. Là encore, une personne refuse de penser, de s’exprimer, répétant et ânonnant des éléments de langage qu’il semble ne pas comprendre, ne pas penser. Il refuse d’interpréter. S’exonère de toute responsabilité. Il se présente comme l’automate d’un autre automate.
Dans sa déposition, Fox, expliquera la méthode : il récupère de courtes descriptions de projets de demandes de financement et les soumet au chatbot avec une instruction minimaliste « Ce qui suit a-t-il un quelconque rapport avec la DEI ? » en exigeant une réponse très courte. Fox ne cherche pas à comprendre comment ChatGPT interprète la notion de DEI, ni à vérifier les réponses. Le chatbot devient le filtre, qu’importe les projets. Dans la logique du chatbot, toute recherche évoquant la race, le genre ou les minorités devient suspecte. Une archive sur les langues autochtones d’Alaska est signalée pour avoir le potentiel de promouvoir l’inclusion. Un documentaire sur le travail forcé de femmes juives pendant la Shoah est également jugé problématique.
Avant même d’utiliser ChatGPT, Justin Fox crée une « liste de détection » (c’est ainsi qu’il nommera son fichier Excel) : une liste de mots-clés pour filtrer les projets. Cette première liste de 49 mots sont ceux qui sont venus spontanément à son auteur. Parmi eux, citons par exemple LGBTQ+, BIPOC (un acronyme qui fait référence à des programmes pour les Noirs, Autochtones et aux personnes de couleur), immigrants, tribal, gay, indigène… Les premiers mots de la liste sont LGBTQ puis homosexuel. Mais on ne sait pas si cette liste sera utilisée ni comment. Cette première liste de 49 mots sont ceux qui seraient venus spontanément à son auteur. Elle sera corrigée. Complétée. Amendée. Utilisée. Pour Alduy, c’est là la liste originelle. On ne sait pas vraiment si Fox a composé la liste lui-même, ou si elle a été produite à l’aide d’une requête sur ChatGPT. Certains mots semblent étranges. Certaines absences également. C’est une réponse que nous n’aurons pas. L’arbitraire est-il le fait de l’homme ou de la machine ? Quelque part entre les deux certainement, comme le souligne Thibault Prévost Dans Technologie du coup d’Etat : « l’IA fournit à l’arbitraire un vernis de rationalité et de respectabilité ». C’est exactement l’endroit où nous sommes, où la liste se situe.
Dans les 5 heures de vidéo de l’interrogatoire de Fox, celui-ci se décrit comme un exécutant, recruté au Doge pour appliquer les décrets du président. Fox était interrogé dans le cadre d’une plainte déposée par l’Authors Guild, l’American Council of Learned Societies, l’American Historical Association et la Modern Language Association… des associations qui ont vu leurs subventions par le NEH annulée. Or, celles-ci étaient jusqu’alors attribuées selon un processus rigoureux, chaque projets étant évalués par des spécialistes. Mais d’un coup, ce n’était plus la qualité scientifique des projets qui était évaluée, mais leur contenu idéologique. Enfin pas vraiment. La méthode employée par Fox montre surtout qu’elle consistait à utiliser l’IA pour ne pas avoir à faire le moindre travail. Que l’arbitraire du jugement produit par l’IA, tout comme l’arbitraire de la liste, était finalement ce qui était recherché.
L’éradication de mots n’est « que le prélude à l’annulation des personnes que ces mots désignent », rappelle Alduy. Les personnes protégées de la discrimination deviennent les catégories des personnes attaquées. On retrouve bien là, l’inversion, l’upside down, lexical mais également fonctionnel. On assiste à un changement de finalité qui modifie la réalité, comme quand nous évoquions l’application CBP One, celle qui permettait aux immigrants de faire une demande d’asile et qui, avec l’arrivée de Trump, est devenue une application de partage d’information avec les services de police pour localiser les demandeurs d’asile et les arrêter. « Les finalités sociales sont transformées en finalités policières. La confidentialité même des données est détruite », écrivions-nous. Même chose partout désormais : dans le nouvel ordre du langage où celui-ci devient le pouvoir, les mots changent de valeur et de fonction. Le sens est mis à l’envers. Le 23 juillet 2025, le président d’une agence fédérale demande à l’université de Pennsylvanie une liste pour identifier les étudiants, professeurs et employés juifs du campus afin de collecter des informations à charge dans un procès lancé par cette même agence contre l’université qui aurait laissé prospérer l’antisémitisme sur le campus depuis le 7 octobre 2023. Upside down. L’inversion du sens des mots change l’ordre du monde. Pour censément protéger une partie de la population, on la liste. L’horreur se retourne comme un gant.
Une liste : « ça s’exécute »
Cette liste qui existe sans exister ne se lit pas. Elle n’est pas disponible. Elle n’est pas produite officiellement par le décret de Trump, rappelle Cécile Alduy. Dans un article de Reuters évoquant une liste de termes interdits à la FDA (l’agence des produits alimentaires et médicamenteux), la Maison Blanche a même démenti son existence tout en confirmant son existence. A défaut d’être, la liste se construit par l’enquête, celle des journalistes notamment qui récupèrent des mails de termes interdits, et qui tentent de repérer les mots qui disparaissent dans les mises à jour du web. Et cette même liste produite par l’enquête devient LA liste utilisée par les bureaucrates pour procéder à leur chasse lexicale, d’un simple copié-collé. « Une liste, ça ne se lit pas, ça s’utilise ». « Une liste ne se justifie pas, elle s’impose ».
La liste est surtout matricielle. Elle se complète d’une disparition l’autre. Jamais définitive. Elle liste les phobies du camp présidentiel ou les peurs de ceux qui le craignent. Elle s’attaque non seulement à la langue, mais derrière elle, elle attaque aussi les gens, les choses désignées par ces mots. Alduy rappelle qu’une liste « ça s’exécute ». Une liste ordonne. Une liste ne laisse aucune place à la pensée (tout comme les réponses des chatbots nous enlèvent la charge de penser). « La liste comme type de texte favorise l’obéissance facile ». Elle est un mode d’action en soi. Elle désigne tout ce qu’il faut écarter. Elle dresse une cartographie pour révoquer ceux qui sont désignés. La liste dit aussi l’inverse de ce qu’elle annonce, puis qu’elle liste ce qu’il faut rendre invisible, sans pointer ce qui par défaut est rendu visible. Ce sont ceux qui espèrent maintenir la hiérarchie raciale qui interdisent le mot race. Ce sont ceux qui sacralisent la liberté d’expression qui la réduisent. Elle rend impossible certaines politiques et rend illégal le vocabulaire de l’adversaire.
La solidité d’une démocratie repose pourtant sur le respect du sens des mots, rappelle la chercheuse. Quand celui-ci vacille, c’est la démocratie même qui s’écroule. Et c’est bien là où nous sommes aujourd’hui. Partout, les mots semblent être détournés de leurs sens. Comme s’ils étaient tous devenus, non seulement des mots, mais des vecteurs dans un espace qui n’a rien de latent, mais qui semble au contraire manifeste et même suractif. Les mots semblent être devenus partout des armes. Leur sens semble partout inversé, comme si l’inversion de leur sens nous projetait dans une réalité alternative, un monde à l’envers. Trump publie un décret intitulé « Restaurer l’excellence scientifique » au moment même où l’administration annule des milliers de programmes de recherche. Les mesures de rétorsion, de destruction, d’annulation sont baptisées « réparations ». Bien sûr, nous pensons tous à l’usage orwellien du langage de 1984, à renverser le sens des mots : « La guerre c’est la paix…» et la dépossession qui en résulte. Dans l’Amérique de Trump, l’effacement du langage va de pair avec une forme d’obsession pour la nomination, comme si nommer était un moyen pour cadrer et régner à l’image du fameux golfe d’Amérique. Des effets qui seraient risibles s’ils n’étaient pas immédiatement mis en œuvre, changeant de noms sur tous les téléphones des Etats-Unis aussi immédiatement que le décret est signé. Et c’est peut-être là finalement que cet effacement, que ce grand remplacement des mots prend tout son sens : dans le fait qu’il s’inscrit immédiatement. La liste produit son effet immédiat, sur les pages web qui disparaissent sur les écrans qui se réécrivent dès la mise à jour faite. D’un coup, la puissance de la langue semble se mettre en action. Pas partout. La réalité n’est pas la même si votre téléphone borne au Mexique ou en France. Ce qui se fissure ce ne sont pas seulement des mots, c’est aussi une réalité commune. Alduy parle d’une « prestidigitation digitale instantanée », remplaçant des mots par d’autres. Derrière la disparition des programmes DEI et du langage qui les rend possibles, la liste des termes proscrits permet de faire disparaître le langage du militantisme, de l’émancipation, des sciences sociales. Le « Diversité, Équité et Inclusion » est renversé par son sens antonyme : « Uniformité, iniquité et exclusion », sans que ce sens ne soit lui-même visible. Ce qui est supprimé laisse aussi invisible ce qui est affirmé.
La liste nous invite dans l’esprit de la machine
La liste est aussi une matrice, un creuset, une matière à délation, à condamnation et pas seulement à disparition, explique Alduy. La chercheuse rappelle d’ailleurs qu’en 2016, une première directive de Trump avait interdit une liste de 7 mots (vulnerable, entitlement, diversity, transgender, fetus, evidence-based, science-based) conduisant par exemple à bannir le terme transgenre de tous les documents du ministère de la santé. La liste est un programme qu’il suffit de répéter pour le rendre effectif. Elle n’existe pas dans le décret et pourtant dans l’administration, des gens l’appliquent. La censure est anticipatrice. L’injonction à la censure reste vague ce qui la rend puissante pour les zélotes. Elle provoque une psychose. On interdit des mots et on s’interdit des mots… La liste se complète, s’étoffe, de synonymes en oublis.
L’idée de la liste « innocule le virus de la liste comme automatisme ». La liste nous invite à classer machinalement, comme une machine. Comme l’IA, la liste trie, classe, discrimine. Les mots, les choses, les gens. La liste nous invite dans l’esprit de la machine. La liste est facile à produire et à reproduire. Elle se duplique. Viralement. Se dissémine. La liste conduit à entendre les anathèmes que produisait la sphère Maga depuis longtemps et que les progressistes refusaient d’entendre. La liste rend le délire réel. Et nous force en retour à choisir nos mots. La liste va au-delà de la liste, puisqu’elle permet par exemple de fabriquer des tests de loyautés idéologiques comme ceux qui sont institués pour les fonctionnaires fédéraux. La liste produit ses effets, de la suppression des mots à la suppression des postes de scientifiques et des données de la science.
JD Vance l’avait annoncé avant de devenir vice-président des Etats-Unis : « Si nous voulons accomplir ce que nous voulons, nous devons, honnêtement et agressivement, attaquer les universités de ce pays ». L’arrivée de Trump au pouvoir a depuis multiplié les attaques, menaces et coupes des financements de l’enseignement supérieur. Alduy en raconte très concrètement la réalité : la fermeture de programmes de recherche, la disparition de disciplines entières, la suppression de bourses, la suspension des demandes de visa étudiants, quand les grandes universités comptent entre 16 et 25 % d’étudiants internationaux. Les « lieux où l’on apprend à utiliser le langage pour penser » sont les premiers visés, comme nous le racontions nous-mêmes en évoquant la montée de la contestation de l’IA à l’école. Alduy dresse le parallèle avec l’invasion de l’IA dans les études supérieures, avec la force politique et financière des entreprises de l’IA, qui non seulement déploient leurs outils pour penser à nos places, mais les déploient également pour croiser les données et armer la répression, révoquer les visas, surveiller les réseaux sociaux. Comme si cette lutte contre le langage n’était possible que via l’arme qui la rend possible : le numérique qui permet de produire des listes, des scripts réplicables et disséminables, et l’IA, qui va être le fer de lance de l’administration Trump, comme le raconte parfaitement bien le journaliste Thibault Prévost dans son livre.
Nous sommes confrontés à une asymétrie de pouvoir inédite et un exercice du pouvoir qui repose sur la représaille produite par une armée de sycophantes et de serviteurs zélés, explique la chercheuse. Mark Zuckerberg n’a pas attendu le moindre décret présidentiel pour mettre fin aux efforts de son entreprise en matière de diversité, rappelle Alduy. Dès le 10 janvier 2025, avant l’investiture, il supprime ses programmes DEI et le fact-checking. D’innombrables multinationales (Coca-Cola, Google, McDonald, Warner Bros, Target…), longtemps à l’avant-garde de la représentativité, lui emboiteront le pas. L’équité et la diversité sont devenues d’un geste, d’une signature de Trump sur un décret, des valeurs à géométrie variable. Les décrets offrent un plan d’action : censure, licenciements, démantèlement, incitation à la délation… Les premiers sycophantes, ces flagorneurs, ne sont pas tant les outils de la tech, que les patrons de la Tech envers le pouvoir. « L’âge de l’IA coïncide avec le retour d’un système de courtisans et d’obéissance verticale sycophantique ». En français, rappelle la sémioticienne, le sycophante ne désigne pas tant un flagorneur qu’un délateur d’ailleurs. Courtisans et délateurs semblent être devenus la double face d’une même lame.
Alduy raconte la réalité qui touche désormais les Américains de papiers, face à la « dénaturalisation ». La nationalité est désormais révocable. A l’heure du calcul permanent, les droits sont désormais révocables, annonçait le philosophe Achille Mbembe dans Brutalisme. Et ce très concrètement : les exactions de l’ICE à capturer des individus pour les envoyer en camp de détention, sans pouvoir contacter leur famille ou parler à un avocat, en les retenant pour des durées indéfinies, sans avoir autre chose à se reprocher que la révocation unilatérale d’un visa. Lister permet de produire des outils de filtrages simples et accessibles, permettant de faire changer leur fonction d’un clic, comme quand le Doge a délibérément reclassé 6000 immigrés comme décédés dans les bases de la sécurité sociale, alors qu’ils étaient bien vivants.
Les centres de détention de l’ICE accueillent des gens qui n’ont plus d’existence légale ni droits, dans un espace de vide juridique, laissé vide, volontairement. « Le futur avance plus vite que nos peurs », écrit Alduy. « L’horreur avance plus vite que nos craintes », pourrions-nous ajouter. Pour la professeure, comme nous y invitait Naomi Klein dans Le Double (Actes Sud, 2024), nous n’avons pas assez fait attention aux mots de l’extrême-droite. « Nous avons cru qu’ils utilisaient le langage comme nous : pour convaincre, pour créer, pour penser, pour figurer, pour métaphoriser, pour comprendre. Alors qu’ils utilisaient le langage sans fioritures comme un instrument de domination ». Quand JD Vance dit que « les université sont l’ennemi », ce n’est pas de l’emphase rhétorique : c’est un programme politique !, rappelle la chercheuse. « Nous n’avons pas assez pris au sérieux leurs mots ». « Ce ne sont pas des manières de parler. Ce sont des manières de penser. Et – aujourd’hui aux Etats-Unis, demain en France – des manières de gouverner ».
« La langue est plus vraie que celui qui la parle », disait Victor Klemperer dans LTI, la langue du IIIe Reich. La langue Maga explique le nouvel ordre qu’elle espère instaurer. « Les listes, le superlatif permanent, l’hyperbole à outrance, l’injure, les antithèses structurantes, ne sont pas des ornements, mais des dispositifs signifiants : les outils de construction d’un monde manichéen régi par la loi du plus fort ». Pervertir le sens des mots de tous, confisquer le vocabulaire adverse, expurger le dictionnaire, désarticuler la pensée… détruire la capacité de raisonner en est la conséquence. Utiliser des moyens de rétorsion pour imposer sa langue, et avec elle, sa vision du monde également. C’est ce que produit la liste. « Ce qu’on ne peut plus dire, on oublie de le penser » : interdire de nommer des structures de domination, occulter la réalité, empêche de les transformer.
Intervenir sur les mots vise à « faire échec à la pensée ». Nous sommes confrontés à une langue pour ne pas penser. De chiffres pour ne pas penser, comme quand Pangram écrase un texte d’un chiffre pour nous écraser de la réduction qu’il produit. Nous sommes désormais renvoyés à une langue plus pauvre, au vocabulaire limité, réduit à un usage transactionnel, fonctionnel, utilitariste. A un manichéisme simpliste, Femme/Homme, Noir/Blanc, Diversité/Majorité… La liste, par son caractère manichéen, produit de l’antagonisme, du clivage, qui oppose amis aux ennemis, fidèles et traîtres, eux et nous. Elle produit une rhétorique qui invite à « une réaction viscérale et une loyauté irréfléchie ». Le sentiment doit supplanter la pensée disait Klemperer. L’opposition binaire invite au campisme, à désigner un ennemi, comme quand on nous invite à choisir entre la Violence et la République. Répondre au campisme consiste souvent à en proposer un autre. A opposer des réalités sans plus aucun débat possible. Les néologismes, les attaques ad hominem, les épithètes dévalorisantes, les amalgames sont utilisés pour dévaloriser l’adversaire, l’essentialiser par le genre, la race, la couleur politique. Alduy parle d’idiolecte, de terme pour interdire les mots des autres. En linguistique, l’idiolecte désigne l’ensemble des usages du langage propre à un individu donné, c’est-à-dire à une langue qui n’est plus parlé que par quelques-uns. Mais cet idiolecte pourrait être aussi le langage de l’idiocratie. Une mère assise dans une voiture devient une « terroriste domestique », comme Kristi Noem, la ministre de la sécurité intérieure, a qualifié Renee Nicole Good quelques heures après son meurtre par un agent de l’ICE. L’idiolecte vise à écraser le pluralisme, à imposer une seule vision du monde, il permet « de réduire la focale sur les obsessions d’une minorité et d’imposer un seul filtre, une seule langue, une seule idéologie ».
Pour Alduy, nous entrons dans un nouvel ordre du langage, totalisant, qui impose d’adhérer à ses fictions. Qui nous invite à abandonner la langue (le logos) « dans sa capacité raisonnante et universelle au profit du mythos, le mythe sous forme de récits alternatifs déconnectés de tout ancrage factuel et le pathos », la réponse purement émotionnelle, impulsive. « Croire dans l’absurde est une vraie démonstration de loyauté ». On assiste à une alliance entre idéologie et rhétorique pulsionnelle qui produit un « prêt-à-penser qui filtre la complexité du monde et la remplace par une image simplifiée, claire, tranchée, une histoire de bons et de méchants ». Qui permet de manifester ses croyances, comme le propose la désinformation augmentée par l’IA. « Les faits dépendent entièrement du pouvoir de les fabriquer ». Le langage ainsi détourné « croit en la force plus qu’en la vérité ». Pourtant seule la langue nous hisse « au-dessus du rapport de force brut », rappelle la spécialiste des mots. C’est la langue, la parole, qui produit la réparation et la justice. Nous avons bien plus besoin d’ajouter des mots à nos dictionnaires plutôt que d’en retirer.
Détruire : la nouvelle fonction du langage
Lire D’abord ils sont venus chercher les mots par ces temps troublés inspire nécessairement plusieurs réflexions.
D’abord, il nous rappelle que les mots, et le capitalisme qui les exploite désormais, ne font pas que dévorer le monde, ils le transforment. Comme s’ils étaient désormais dotés d’une fonction performative immédiate, une capacité d’agir, une agentivité rendue possible par les systèmes numériques eux-mêmes. On le sait déjà depuis longtemps, dans les systèmes numériques, la liste (qui est le résultat du tri et du classement) est une fonction phare des outils informatiques.
La liste des mots interdits par l’administration Trump, fait indéniablement écho à d’autres listes. Celle des mots interdits de Google Photos (et qui le sont toujours), à celle des URL interdites que se partagent les opérateurs dans la traque des sites de téléchargement illégaux comme des sites de phishing, à celle des filtres de censure des IA génératives russes qu’évoquait la chercheuse Ksenia Ermoshina. Là où le rapport à la langue est le plus construit, le filtrage et la censure restent traités avec des solutions bricolées. Comme disait déjà le chercheur Tarleton Gillespie dans Custodians of the internet (2018, Yale University Press, voir notre lecture) : le filtrage, via des listes noires, n’est pas très probants et produit une censure trop forte, très facilement contournée pourtant par des techniques d’obfuscation élémentaire, comme d’introduire des fautes d’orthographe ou des caractères étranges. Toutes imparfaites qu’elles soient, le risque, pourtant, est bien que ces techniques se démultiplient, sans que les utilisateurs ne soient sûrs de l’effet produit, car bien souvent, l’interdiction n’est pas directe, mais restreint surtout la portée des messages comportant les termes interdits. Le projet d’interdire les termes appelant à la violence sur les réseaux sociaux, comme le projette la loi dite casseurs-payeurs (qui vise surtout à faire payer d’autres personnes que les casseurs, en introduisant des moyens d’enquêtes qui reposent sur une surveillance sans limite et qui est d’abord une attaque contre le droit à manifester), ne cesse de renouveler la promesse de la liste : censurer sans se montrer, modérer sans le dire, interdire sans l’avouer et punir par l’arbitraire.
Malgré les défaillances de ces listes, elles nous rappellent que les mots ont désormais une fonctionnalité. Et que le passage de la modération à la censure, n’est plus rien d’autre qu’un glissement d’opérations dont rien ne nous prémunit, caché derrière l’opacité des plateformes. Dans la confusion des innombrables formes de modération qui se propagent dans la plus grande opacité, plus rien n’est clair, comme quand Bluesky s’arroge le droit de bloquer des liens vers une fuite de données sur les agents de l’ICE.
La liste propage à la fois la signose et le glissement. Elle permet à la fois de « prendre le signal pour la chose », c’est-à-dire de transformer le signe (le mot) en signal (celui qui le prononce le défend) et de produire « le glissement », c’est-à-dire le changement de finalité. La liste rend les mots fonctionnels, quelles que soient leurs défaillances. Et c’est bien cela qui devrait nous inquiéter. Les techniques de modération sont les mêmes que les techniques de censure.
Mais la censure, même algorithmique, est toujours défaillante. Si elle est plus active sur certains que sur d’autres comme le remarquait déjà Gillespie, ses modes opératoires restent extrêmement frustres. Et c’est cela que souligne Cécile Alduy dans son livre. Son mode opératoire. Son flou. La liste n’est jamais vraiment produite, jamais claire, toujours mouvante. Ses effets le sont tout autant. A la fois réels et putatifs, à la fois lourds et évanescents, à la fois concrets et potentiels. A l’heure du capitalisme du langage, les mots ne sont pas tant de l’argent, ils sont d’abord transformés en armes par les systèmes numériques eux-mêmes. Quant à croire que le trumpisme ne nous menace pas, la Commission consultative des droits de l’homme s’est récemment inquiétée du risque que le CNRS retire les thématiques « égalité femmes-hommes » , « inégalités » et « discriminations » de ses priorités de recherche. Avant de recevoir l’assurance du contraire… Pour l’instant.
L’autre enjeu qu’évoque assez peu directement le livre de Cécile Alduy, c’est bien sûr le rôle et la place de l’IA dans la production de l’arbitraire. Alors bien sûr, confrontés désormais aux bullshiteurs, aux « simulateurs de conversation » on pourrait croire de la même façon, que l’IA est un outil pour penser, pour comprendre… alors que lui aussi, doit être d’abord lu comme un instrument de domination. La concomitance du fascisme et des outils de production de langue ne semble pas tenir du hasard, tant l’un est mis au service de l’autre. L’IA semble d’abord recouvrir l’arbitraire de ses calculs d’un vernis de science pour les rendre acceptables, alors qu’ils sont d’abord rendus irredevables. L’IA semble surtout un outil pour implémenter et renforcer l’irresponsabilité de l’État comme des entreprises qui la mobilise. Discriminer sans le montrer est certainement la première fonction de l’IA. Et détruire, par delà les mots, nos capacités même de penser, l’inquiétude qui devrait nous alarmer.
Hubert Guillaud
- Persos A à L
- Mona CHOLLET
- Anna COLIN-LEBEDEV
- Julien DEVAUREIX
- Cory DOCTOROW
- Lionel DRICOT (PLOUM)
- EDUC.POP.FR
- Marc ENDEWELD
- Michel GOYA
- Hubert GUILLAUD
- Gérard FILOCHE
- Alain GRANDJEAN
- Hacking-Social
- Samuel HAYAT
- Dana HILLIOT
- François HOUSTE
- Tagrawla INEQQIQI
- Infiltrés (les)
- Hugues JALLON
- Clément JEANNEAU
- Paul JORION
- Christophe LEBOUCHER
- Michel LEPESANT
- Notes (LePartisan)
- Persos M à Z
- Henri MALER
- Christophe MASUTTI
- Jean-Luc MÉLENCHON
- MONDE DIPLO (Blogs persos)
- Richard MONVOISIN
- Corinne MOREL-DARLEUX
- Timothée PARRIQUE
- Thomas PIKETTY
- VisionsCarto
- Yannis YOULOUNTAS
- Michaël ZEMMOUR
- Gafam / IA (LePartisan)
- Numérique
- Thomas BEAUFILS
- Blog Binaire
- Christophe DESCHAMPS
- Dans les Algorithmes
- Louis DERRAC
- Olivier ERTZSCHEID
- Olivier EZRATY
- Framablog
- Fake Tech (C. LEBOUCHER)
- Romain LECLAIRE
- Tristan NITOT
- Irénée RÉGNAULD
- Nicolas VIVANT
- Collectifs
- Arguments
- Scientifiques en Rebellion
- Bondy Blog
- Dérivation
- Économistes Atterrés
- Dissidences
- Mr Mondialisation
- Palim Psao
- Paris-Luttes.info
- Rojava Info
- X-Alternative
- Créatifs / Art / Fiction
- Nicole ESTEROLLE
- Julien HERVIEUX
- Alessandro PIGNOCCHI
- Laura VAZQUEZ
- XKCD