05.10.2026 à 22:14
Lycées et universités. La révolution du peu. La colère de tant. (et comment aussi au milieu de tout ça Parcoursup est devenu Parcourspute)
Olivier Ertzscheid
Texte intégral (2379 mots)
Nous avons tellement appris à nous contenter de peu. De si peu. Et de faire de ce si peu le seul horizon d’espérance, de combat, de lutte, d’espoir, ou d’abandon. Vous allez travailler un peu plus longtemps. Vous allez payer un peu plus cher mais vous serez payés un peu moins qu’avant (l’inflation … tout ça …). Il y aura un peu plus de pollution dans chaque parcelle de vos vies. Un peu plus, un peu plus, un peu plus … de misère, de difficultés, de centimes aux prix à la pompe …
Et depuis quelques jours c’est une autre génération du peu, qui se lève et nous rappelle à l’essentiel de nos luttes oubliées, abandonnées ou résignées. Une génération du peu. Une génération pour qui il y a un peu plus d’élèves par classe. Un peu plus de professeurs non-remplacés. Un peu plus de lycées et de collèges délabrés. Un peu plus de problèmes de santé mentale et un peu plus d’attente avant d’avoir une place chez un psy ou chez l’infirmière ou la psy du lycée qui est affectée sur un peu plus d’établissements et à donc un peu plus d’élèves à voir. Et puis dès le collège un peu plus de choix à faire sur des lycées et des enseignements de spécialité qui compliqueront un peu plus un futur incertain et qui ajouteront un peu plus aux projections impossibles et donneront lieu à un peu plus d’inquiétude chez certains, à un peu plus d’angoisse chez d’autres.
Et puis après il y aura un peu plus de voeux à faire sur Parcoursup mais il y aura encore un peu plus d’universités incapables de les accueillir de manière digne parce qu’il y a chaque année un peu plus d’universités qui crèvent de sous-financements.
Ah et puis aussi il y a la chaleur. Il fait un peu plus chaud vous avez remarqué ? Alors ils et elles crèvent un peu plus de chaud (leurs profs aussi) dans leurs salles de classe un peu plus bondées, dans des lycées et collèges toujours un peu plus chauds. Heureusement on leur promet ils passeront leur brevet et leur bac un peu plus tôt le matin.
C’est comme pour les manifestations, voyez. A chaque fois un peu plus de violences policières et un peu plus tôt dès le début du mouvement. Un peu plus de mutilés. Un oeil crevé. Une mâchoire et une dentition explosée. Une main arrachée. On parle là de mineurs de moins de 17 ans. On parle de nos gosses. De trois gamins handicapés à vie. On parle de Maël, 16 ans,qui a perdu son oeil. On parle d’Eden, 14 ans, qui a eu la mâchoire brisée par un tir de flashball. On parle de ce « lycéen de 15 ans », qui a eu la main arrachée. On parle de plus de 5000 personnes en garde à vue dont près de 90% de mineures et de mineurs, Et pour ceux-là, « 48h d’enfer« , des ITT, des syndromes de stress post-traumatique chez des gamins de 16 ans. Pour avoir manifesté. Pour s’être manifesté. Et le néant.
Devinette: sachant que deux lycéens majeurs ont respectivement été condamnés à cinq mois de bracelet électronique et huit mois d’emprisonnement avec sursis pour le jet d’une pierre (qui n’a pas atteint sa cible) et celui d’une bouteille d’eau sur un policier (qui ne l’a pas atteint non plus) le vendredi 2 octobre à Strasbourg, de quelle condamnation écoperont les policiers qui ont brisé la mâchoire d’Eden, éborgné Mael, et lancé la grenade qui a arraché la main d’un lycéen et 15 ans. Et quand ?
C’est compliqué de les entendre parce qu’il faut pour cela franchir des murs de vieux cons très loin ce ces soucis du peu, et qui ressassent avec d’autres mots les « passe ton bac d’abord » que l’on entendait encore hier. Comme hier ils leur disent : « allez bosser », « regardez les petits chinois », « vous êtes des privilégiés », « retournez en classe le monde ne va pas vous attendre », « les autres ils finissent pas à 17h ».
Compliqué donc de les entendre au milieu du fracas et des obsessions médiatiques de la poubelle brûlée ou du casseur masqué (ah ben non tiens, finalement c’était un policier déguisé infiltré libéré délivré). Mais c’est facile de les écouter. Les lycéennes et les lycéens. Et quand on écoute attentivement, quand on essaie en tout cas, ce qui me frappe le plus ce sont leurs revendications et leurs rêves. Ils et elles n’ont pas de rêve de grand soir, ce ne sont pas les héritiers d’échevelés gauchistes de tribune ou les petits-fils commodes de « soixante-huitards » frustrés. Ils ne demandent pas l’abolition du capitalisme, la fin des interdits, le SMIC à 3000 euros ou que le MEDEF soit classé comme organisation terroriste.
Ils et elles n’ont que peu de revendications. Des revendications du peu. Des rêves de peu. Mais ce peu est sensible. Ils voudraient juste un peu plus de profs. Ils voudraient juste un peu moins d’élèves par classe. Ils voudraient juste que les profs absents soient remplacés un peu plus vite et un peu plus systématiquement. Ils voudraient juste avoir un peu moins chaud dans leurs salles de cours. Un peu moins de plafonds qui leur tombent sur la gueule, un peu moins de locaux délabrés. Que le travail scolaire soit un peu moins pénible, car oui il y a une pénibilité du travail scolaire aujourd’hui qui n’est pas tant lié au travail scolaire lui-même mais à tout ce qui l’encadre, le norme, l’écrase, l’impose. Ils voudraient aussi, un peu moins de mépris.
Ah si j’allais oublier. Ils et elles veulent l’abrogation de Parcoursup et là tout le monde les traite, au mieux, de doux rêveurs ou de dangereux radicaux. Parce que c’était pas mieux avant (souvenez-vous les vieux, le tirage au sort d’APB, souvenez-vous les très vieux, les files d’attente premier arrivé premier inscrit) et qu’on ne pourrait soi disant pas faire mieux. Pas même un peu mieux. Sérieusement ? Mais vous avez-vu ce que Parcoursup est devenu ? L’année dernière on nous expliquait qu’il était sérieusement envisagé que le SNU (Service national Universel) puisse rapporter des points bonus si on s’y engageait (on a pour l’instant heureusement évité cette merde). Cette année on nous a dit que les années de césure pour cause d’engagement militaire seraient acceptées quoi qu’il arrive et sans nous demander notre avis. Et là, il y a quelques semaines on faisait face à un rebranding violent dans lequel Parcousup devenait tout simplement Parcourpute ou ProstiSup (pardon aux camarades TDS). La passe est à trois mille euros, ce sont les proxénètes Edouard Geffray et Philippe Baptiste qui fixent les prix. Parce que figurez-vous que nous en sommes-là. Les rectorats et services du ministère font directement du phoning, ils appellent les universités pour leur dire, « alors si vous nous prenez un des recalés de Parcoursup qu’on n’arrive pas à caser – vu que nous sommes fin septembre quand même hein … et qu’il en reste plusieurs milliers – alors on vous file 3000 euros. Cash. 3000 euros le lycéen. 3000 euros la lycéenne. Parcourpute. Attention hein, vous le ou la prenez en 1ère année mais on ne vous file les 3000 euros qu’une seule fois. Faut pas déconner non plus. Et si vous nous en prenez 50, alors on vous file un poste d’ATER pendant un an. » Je vous jure que lorsque j’ai lu cette information dans Le Monde et dans Médiapart je n’y ai simplement pas cru. Et puis après, et depuis, je suis tellement en colère. Et surtout j’ai tellement honte. Tellement honte. Tellement.
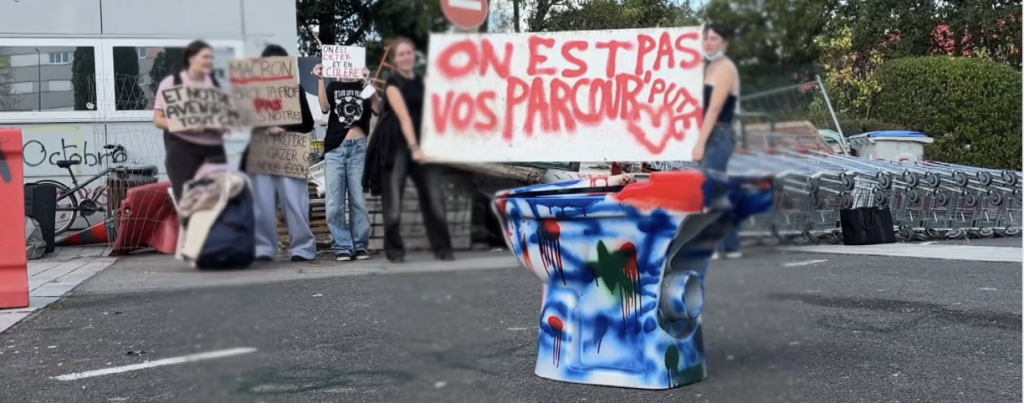
(screen d’un reportage de Télé Nantes)
Moi j’ai 54 piges, j’ai fait ma première grève et séché mes premiers cours contre le projet Devaquet. Depuis j’en ai fait d’autres. Plein. Vraiment. Puis j’ai vieilli, je me suis embourgeoisé, et si je me raconte du fond de mon canapé italien que j’appartiens toujours à la gauche radicale, j’ai au moins la décence ou la lucidité de reconnaître qu’a minima j’ai l’indignation confortable, la colère replète et la radicalité molletonnée : je n’ai pas faim, je n’ai pas froid, la fin du monde m’inquiète mais pas la fin du mois. Et pourtant. Et pourtant. Pourtant même moi quand je vois ça j’ai juste envie de tout cramer à commencer par le fondement, non pas de la démocratie représentative, mais de quelques-unes et quelques-uns des furoncles politiques qui osent encore faire croire qu’ils représentent qui que ce soit d’autres qu’eux-mêmes ou les intérêts de leur propre classe, toujours dominante.
Demain, mardi 6 Octobre j’ignore ce qu’il se passera. J’ignore aussi après-demain. Ce que je sais c’est que ces gosses, ces ados, ces presqu’adultes, sont citoyens. Et que notre rôle, notre seul rôle, notre rôle de parents, d’éducateurs, d’enseignants, d’élus, notre seul rôle c’est de les accompagner sans cesse, de les écouter sans trêve, et désormais donc face à un pouvoir qui pète des mâchoires, explose des mains, et crève des yeux d’adolescentes et d’adolescents, de les protéger sans relâche. D’aller mettre nos mains, nos mâchoires, nos yeux et nos corps pour protéger les leurs.
Cette jeunesse là est grande, elle l’est immensément. Cette jeunesse là est fragile, elle l’est immensément. Elle est à la fois grande et fragile parce comme aucune autre jeunesse avant elle, cette jeunesse est raisonnable. Elle est juste raisonnable. C’est peut-être cela qui met le pouvoir en ébullition et en panique. Pas l’insurrection qui vient. Mais qu’une insurrection puisse venir d’une jeunesse simplement raisonnable. Qui veut juste que ça aille un peu mieux. Cette jeunesse raisonnable a parfaitement compris ce que les vieux cons et vieilles connes qui les toisent n’ont toujours pas commencé à capter. Nos prochains combats seront ceux du peu. Mais si nous sommes incapables de les mener, alors à ce moment là et à ce moment là seulement, il ne sera plus un peu mais beaucoup trop tard pour éviter la bascule dans des radicalités et dans des effondrements irréversibles.
Et pas qu’un peu.
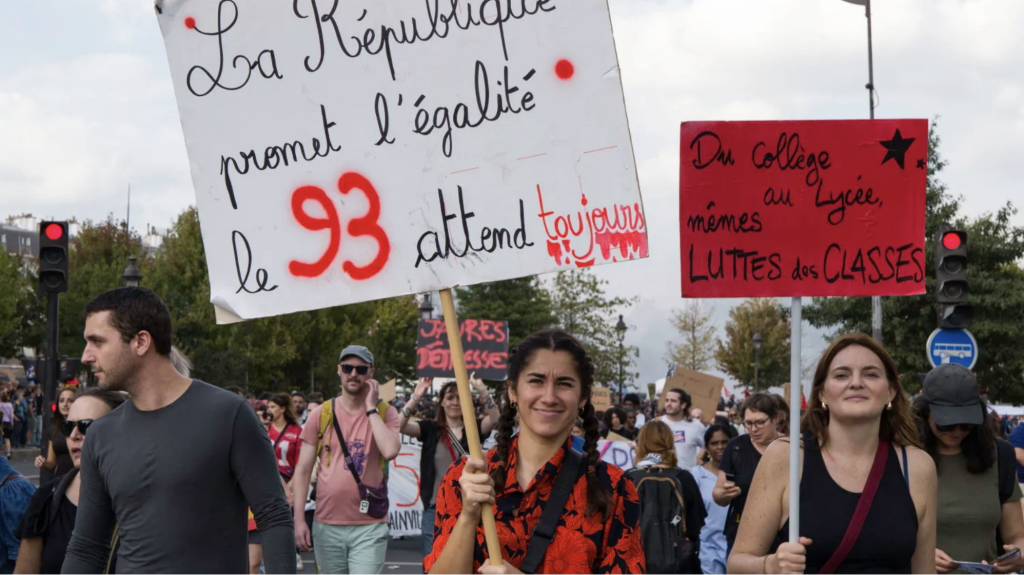
© Eric Broncard / Hans Lucas via AFP
04.10.2026 à 16:42
Hasard et réseaux (Epsiloon)
Olivier Ertzscheid
Texte intégral (748 mots)
J’ai répondu aux question de Gabrielle Antoniewski à l’occasion de la parution du magazine Epsiloon sur le thème « Hasard et Réseaux » (le numéro papier est épuisé mais reste dispo en numérique). Je vous en livre ci-dessous un verbatim et vous invite évidemment à aller jeter un oeil au numéro complet. Le travail de mise en valeur et de prédagogie de la recherche que fait Epsiloon est absolument remarquable.
Est-ce qu’on peut attribuer l’addiction aux réseaux, plus précisément au scrolling, à la part de hasard qu’on y trouve (ne pas savoir ce qui suit) ?
Oui, et y compris avant l’arrivée des réseaux sociaux, le moteur Google avait mis sur sa page d’accueil le bouton « feeling lucky » pour installer dans l’imaginaire l’idée qu’il y aurait une part de hasard dans toute recherche (alors qu’en fait ce bouton ouvrait directement le 1er résultat). C’est l’idée de la « sérendipité », l’idée que l’on puisse trouver et découvrir par hasard quelque chose que l’on ne cherchait pas forcément au départ mais qui va tout de même nous intéresser. Le scrolling procède, en partie, de la même logique : on ne sait jamais exactement ce qui va arriver ensuite mais on anticipe le fait que cela pourrait nous intéresser. La grosse différence c’est que le scrolling ne procède d’aucune démarche déterministe : on ne cherche rien au départ, il n’y a pas de besoin ou de curiosité initiale, ou elle est accessoire.
Si oui, comment expliquez-vous que le mécanisme du scrolling infini soit si addictif pour les utilisateurs ?
Le scrolling infini procède d’une logique initialement perverse qui, en partie sur la base de nos préférences mais essentiellement sur la base de celles d’une majorité d’utilisateurs et de contenus dont la seule valeur ajoutée est de maintenir une audience captive, travaille sur l’abaissement constant du coût cognitif et avec lui de notre seuil de vigilance qui permettrait, par exemple, de se rendre compte que nous sommes essentiellement en train de perdre du temps pour alimenter le business des plateformes.
Quels sont les raisons de cet engouement (la curiosité, la dopamine, etc.) ?
Il y a bien sûr une forme de « chimie » qui est à l’oeuvre dans ce mécanisme de récompense aléatoire. A laquelle s’ajoute aussi un facteur de socialisation « en absence » : en scrollant on s’inscrit aussi dans une sociabilité entre pairs par le marquage ou le repartage de contenus. Nos activités numériques s’inscrivent toujours à la croisée de dynamiques instrumentalisées et orchestrées par les acteurs qui organisent et donnent à voir le contenu (les réseaux sociaux principalement) et de logiques sociales de rattachement, d’appartenance et de mise en visibilité de soi, y compris au travers de micro-tâches semblant anodines.
Est-on d’accord pour affirmer que pour le hasard perçu sur les réseaux sociaux il s’agit d’une illusion créée par les systèmes de recommandation en réalité basé sur des algorithmes précis ?
Oui tout à fait. Et c’est ce qui illustre le mieux la toute puissance de leur capacité d’influence : parvenir à nous convaincre à l’échelle individuelle que nous tombons à la fois sur des contenus originaux et personnalisés (le « pour vous ») tout en organisant, à l’échelle collective, la distribution de contenus massivement homogènes.
24.09.2026 à 09:55
Festival Hypermondes.
Olivier Ertzscheid
Lire la suite (208 mots)
Je serai ce week-end l’un des invités de la 6ème édition du festival Hypermondes.
J’interviendrai le samedi à 13h30 pour une table-ronde sur les liaisons dangereuses entre science et technologie.
Je serai également en dédicace le matin (11h10) et l’après-midi (14h40).
Au plaisir des vous y croiser si vous passez dans le coin.
22.09.2026 à 17:33
C’était ça ou … écrire ?
Olivier Ertzscheid
Texte intégral (1173 mots)
Quelques mots à propos de la polémique qui enfle et enfle encore au sujet du roman « C’était ça ou mourir » de Thélyson Orélien. « Il paraît » qu’il aurait été en grande partie écrit par une IA. « On dit que » des détecteurs d’IA identifient des passages entiers comme « utilisant l’IA« . Les mêmes détecteurs qui sur à peu près n’importe quel texte classique du 18ème, 19ème siècle ou d’avant (donc de l’époque où les IA n’existaient pas) affirment avec autant d’assurance qu’ils ont aussi été écrits avec l’aide de l’IA.
A l’université comme dans tous les espaces critiques, sociaux et politiques dans lesquels l’écriture est socle, on passe notre temps à nous demander si ce devoir, ce rapport, cet article, ce mémoire, cette thèse a été ou non écrit avec l’aide de l’IA et dans quelles proportions. Et les « outils » de détection sont tous, je dis bien absolument tous, à la ramasse. Et bien sûr nous le sommes aussi parfois (mais bien moins souvent ceci dit que lesdits outils).
Thélyson Orélien. C’était ça ou mourir. Je n’ai pas (encore) lu le livre. Pourtant je vais ici vous affirmer qu’il l’a bien écrit, lui et lui seul. Et je suis prêt à parier beaucoup là-dessus. Pourquoi ? D’où sort cette étrange assurance qui en même temps fait aveu de n’avoir même pas lu l’ouvrage.
C’est assez simple. J’ai vu et j’ai surtout entendu Thélyson Orélien quand il est venu parler de son livre dans l’émission la grande librairie. Dans sa voix, son phrasé, dans sa langue, dans ce qu’il dit de son livre et dans la manière qu’il a lui-même de le lire, j’ai été immédiatement frappé, bien avant cette polémique naissante, par ce qu’on appelle un style, une intensité, une singularité, et l’évidence des trois précédents. Je n’ai absolument aucun doute. Comme je n’ai absolument aucune doute sur des rapports rendus par mes étudiants dès lors que je les ai entendu parler et que je les ai lus dans une cadre où l’usage de l’IA était impossible.
D’autres choses frappent dans cette polémique. Evidemment. Thélyson Orélien est noir et haïtien. C’est aussi l’un des derniers ouvrages publiés par Olivier Nora avant son éviction dans les conditions que l’on connaît. Les théories du complot ne jouent pas l’une contre l’autre. Bien sûr. Mais si l’on pose la question de la sincérité de l’écriture alors il faut aussi, et simultanément, poser la question du rattachement et de l’appartenance de cette écriture. Sinon on passe à côté de tout. Et surtout de ce qu’écrire veut dire lorsque l’on est noir, haïtien, poète, exilé, publié chez Grasset par Olivier Nora. Et aussi du fait qu’il écrivait déjà et était déjà salué et primé comme écrivain et poète bien avant l’invention de ChatGPT et des autres outils d’IA.
Dans un article précédent sur l’IA je parlais de la capacité qu’elle a de défaire et de dissoudre toutes les formes de collectif. L’écriture est toujours singulière. La question que pose la polémique lancée contre Thélyson Orélien est d’abord celle de notre capacité à faire collectif autour de la singularité d’une écriture située, comme toutes les sont mais comme la sienne l’est particulièrement. Aux yeux de certains en tout cas.
<Mise à jour>
Parmi les articles à lire qui ne sont pas qu’un ramassis d’amalgames, celui de Numerama fait le taff 
</mise à jour>
<Moralité de deux jours plus tard …>
Alors deux jours plus tard et autant d’emballements médiatiques et de (passionnants) débats plus tard, la réalité toute nue est donc que derrière ce mystérieux compte « Balance ton Claude » se cachait un chroniqueur néo-conservateur du Figaro, qui s’est lancé depuis des années dans une croisade anti-woke.
La morale de cette histoire me semble être la suivante. Désormais il faudra que chaque livre de chaque prix littéraire soit passé au crible de chaque détecteur d’IA existant pour établir corrélations comme avant on agitait potions. Et ce faisant des oracles statistiques seront rendus. Et pour qu’ils le soient toujours davantage d’autres livres nourriront à leur tour presque licitement des bases de données de textes qui serviront d’entraînement aux prochains générateurs de texte qui seront utilisés ou non par d’obscurs auteurs qui soudainement se verront révélés mais aussitôt parfois enterrés après être passés à d’obscurs détecteurs d’on ne saura plus trop bien quoi. Ou alors on se souviendra que Thélyson Orélien était noir, haïtien, exilé, poète, en tête des ventes y compris devant le dernier opus de Sarah Knafo lorsque soudain … Samuel Fitoussi, un néo-conservateur lancé dans une croisade anti-woke et disposant de relais dans un grand nombre de journaux et notamment au Figaro, décida d’en faire sa cible et y parvînt. La chair est triste hélas, et il nous reste des livres à lire.
</Moralité de deux jours plus tard …>
21.09.2026 à 22:19
Un gouvernement de connards. Et un ministre de l’enseignement supérieur qui l’est encore davantage. Chantage alimentaire à l’assemblée.
Olivier Ertzscheid
Texte intégral (1601 mots)
Bon la dernière fois que j’ai insulté une ministre de l’enseignement supérieur, c’était Frédérique Vidal. Je vous laisse fouiller dans les archives, c’est facile à retrouver. On était en 2020, un étudiant venait de s’immoler par le feu et elle lançait un numéro de téléphone (même pas un numéro vert) pour lutter contre le suicide. Numéro qui était ouvert aux heures de bureau (qui sont aussi, c’est bien connu, uniquement celles où on se jette des fenêtres). J’ai franchement autre chose à faire que d’insulter publiquement des ministres et n’en tire ni gloire ni satisfaction mais il y a juste un moment où ce n’est plus possible autrement quoi.
Là nous sommes en 2026, et c’est donc Philippe Baptiste qui est actuellement ministre de l’enseignement supérieur. C’est un euphémisme que de dire qu’il n’est pas le pingouin qui glisse le plus loin sur la banquise, tout comme c’est un euphémisme de dire que, vu celles et ceux qui l’ont précédé, c’est aussi en plein dans ce qui à l’air d’être le seul profil de poste.
Philippe Baptiste à peine nommé s’était déjà illustré en chiant sur la gueule de ses administrés (nous), avec son désormais célèbre « c’est pas Zola non plus« , ce qui, connaissant la situation budgétaire des universités (rappel : c’est son taff en théorie), est un peu l’équivalent du « ça va c’est Gérard » dans le milieu des VSS et du cinéma.
Or donc en quelques jours ce gouvernement annonce par la voix du ministre de la Ville et du Logement, Vincent Jeanbrun, que les APL ne seraient pas revalorisées en 2027. Et que bon « on demande un petit effort à tout le monde. » Je ne sais pas si c’est le mot « petit effort » ou le mot « tout le monde » qui me donne le plus envie de le gifler avec sa dignité perdue (bon en fait je sais, c’est le mot « tout le monde« ). Les pingouins, la banquise, et ce moment où on a envie de prendre un club de golf pour les aider à glisser plus loin.
Et puis donc aujourd’hui voilà l’autre immarcescible quiche qui part dans une dinguerie que même Frédérique Vidal n’aurait pas osée. Il démarre en solo une symphonie du chantage. Du chantage mesdames et messieurs. Du chantage qui prend comme cible les étudiantes et les étudiants. Il dit quoi Philippe Baptiste ? Il dit si le budget n’est pas voté, bah pouf, on ne pourra plus proposer le repas à un euro à tous les étudiants.
Je vous le réécris en toutes lettres tellement le verbatim de son interview dans Ouest-France m’a laissé dans la bouche le goût d’une tartine de merde :
« Si la loi de finances n’est pas adoptée au Parlement d’ici la fin de l’année, nous serons incapables d’assurer le repas à 1 € pour tous. Nous n’aurons pas les moyens financiers disponibles pour le faire. Mais ce n’est qu’un exemple parmi d’autres. Nous sommes sur un budget sérieux où l’on réduit les dépenses tout en finançant des priorités. L’enseignement supérieur et la recherche font partie de ces priorités. »
Un putain de chantage au vote. C’est plus « pétrole contre nourriture » c’est vote du budget de l’état contre possibilité que les étudiantes et les étudiants cessent de crever de faim et qu’on arrête de les relever dans nos amphis parce qu’ils ou elles n’ont pu faire qu’un seul repas hier. Une crevure. Une putain de crevure.
Philippe Baptiste je ne l’ai même pas reconnu au fait qu’il ose tout, parce que je l’avais déjà vu venir avant. C’est juste que je n’ai plus de vocabulaire autre que le champ sémantique de la cuve à pisse pour décrire la capacité de ces furoncles à oser mobiliser de tels argumentaires. Et les mots pour le dire me viennent aisément.
Quand j’ai insulté Frédérique Vidal il y a 6 ans de cela, on était en train de monter une épicerie solidaire. Ce jeudi et pour la 6ème année donc, comme deux jeudis par mois depuis 5 ans révolus, avec une bande d’étudiantes, d’étudiants et quelques collègues, on va distribuer gratuitement des tonnes de denrées alimentaires à des étudiantes et à des étudiants. La Mayo’nnaise épicerie ça s’appelle. On va en chier, on va transpirer, on va courir partout, mais on va le faire. Pendant que le ministre de l’enseignement supérieur lui, il fait du chantage alimentaire à l’assemblée.
Philippe Baptiste je te lance la même invitation qu’à Frédérique Vidal, Sylvie Retailleau, Patrick Hetzel … Viens. Viens voir comment ça se passe une distribution alimentaire. Et si dans les lectrices et lecteurs de cet article il en est qui se disent « oh bah quand même des repas à un euro pour toutes et tous, est-ce que c’est pas un peu trop ? » bah venez jeudi aussi, et on discutera, on vous expliquera, vous les verrez ces fameux « étudiantes et étudiants« . Et si vous n’avez pas le temps ou pas envie, bah alors pardon mais juste allez nager dans la même cuve à pisse que Philippe Baptiste, et n’oubliez pas, tout comme lui, de bien respirer quand vous aurez la tête sous l’eau.
« Un petit effort » hein, « pour tout le monde » hein, allez ça va quoi c’est pas 5 ou 6 euros d’absence de revalorisation des APL qui vont changer votre vie hein. Bah si. Connard. Bah si. Connard.
« Attention hein, si vous ne votez pas notre budget de droite, on va punir les étudiants et ça nous arrangera mais on dira que c’est votre faute nananère« . Franchement ? J’ai cherché et c’est un illustre serviteur de l’état qui résume le mieux ce que je lui aurais dit si j’avais un peu de lettres et d’esprit. « Casse-toi, pauvre con » je lui aurais dit.
La prochaine fois que vous entendrez quelqu’un vous expliquer plus ou moins doctement que l’état se soucie de la jeunesse, dites-lui pour les APL, dites-lui pour le chantage alimentaire, dites-lui pour le reste aussi.
La guerre arrive il paraît. La militaire, la climatique, la générationnelle. Faut se réarmer démographiquement paraît-il. Moi la jeunesse je ne la connais pas davantage que d’autres. Mais c’est vrai que je la fréquente quand même un tout petit peu plus que certains autres. Et je sais juste que celle que je croise tous les jours dans mes amphis et deux fois par mois dans des distributions alimentaires, cette jeunesse là se tient à des hauteurs que beaucoup de ces ministres n’atteindront jamais. Je sais aussi qu’elle est fatiguée. Et qu’elle a faim. Et qu’avant de l’inciter à s’engager au front ou à copuler dans les lignes arrières, faudrait d’abord penser à lui filer à bouffer, lui permettre de se soigner et de se reposer, et puis aussi de continuer d’étudier sans avoir pour cela à s’endetter (puisqu’il paraît que demain aussi, ce sera la fin du « tabou » des frais d’inscription à l’université).
Et je sais aussi qu’on n’a jamais vu aucun ministre de l’enseignement supérieur sur aucune distribution alimentaire. Et que ce n’est pas un hasard.
Et je sais enfin que si la jeunesse se tient loin de la politique ou de certaines politiques en tout cas, c’est juste parce que l’odeur de cette immense cuve à pisse l’incommode. Parce qu’elle vaut mieux qu’un chantage alimentaire.
Je ne sais pas si tu iras au bout de ton chantage à l’aide alimentaire Monsieur le ministre. Mais dans tous les cas, va te faire foutre Monsieur le ministre. Va bien te faire foutre.
20.09.2026 à 16:45
La fable et le mythe. L’IA et la fin des collectifs.
Olivier Ertzscheid
Texte intégral (3523 mots)
Pour archivage personnel et repartage, je reproduis ici le texte paru initialement le 20 Juillet dans la (remarquable) revue AOC.media.
On notera que les modèles les plus puissants d’IA à ce jour – ceux-là que l’on présente comme l’armageddon cyber et le terminator langagier (capable entre autres de lipogrammer en E avec la facilité d’un Mr Jourdain) – s’appellent « Fable » et « Mythe ». Et l’on en déduira ce que l’on voudra mais on se souviendra que le nom de l’IA est avant tout « récit ».
On notera aussi que ces modèles d’IA sont déployés au coeur d’une société baptisée « Anthropic », dont on ne sait plus si le nom est :
- programmatique (tous ces modèles sont anthropiques, c’est à dire faits et conçus par des humains),
- antiphrastique (ils ont vocation à dépasser l’humanité, c’est en tout cas leur « récit »)
- ou paronymique (on lit « anthropic » et l’on entend aussi « entropie » qui dit que quelque chose se transforme, et qui dit aussi l’imprédictibilité de cette transformation).
Derrière ces récits je veux vous conter celui qui affleure si peu et me semble pourtant si déterminant. Le récit de la manière dont l’IA signe la fin des collectifs, de la manière dont elle engage cette fin et des moyens colossaux qu’elle y consacre.
Des travaux de sociologues ont, longtemps après les premiers scandales de la Silicon Valley, permis de documenter pourquoi il n’était pas très étonnant que des biais racistes et sexistes soient présents un peu partout dans les algorithmes des plateformes dès lors que les gens qui les développaient (ces algorithmes et ces plateformes) étaient très majoritairement des hommes jeunes, blancs et issus de milieux aisés ; et comment l’automatisation des inégalités constituait (et constitue toujours) un cadre de référence (lire notamment Safiya Umoja Noble, Kate Crawford, Virginia Eubanks, Olivier Alexandre, Jen Schradie et quelques autres …)
D’autres sociologues, d’autres chercheurs, ont montré que derrière ces technologies, se trouvait un travail invisible, celui des modérateurs et modératrices, asservis dans des formes renouvelées et exacerbées d’un capitalisme tissé de néo-colonialités (cf les travaux d’Antonio Casilli et de Paola Tubaro et ceux de Sarah T. Roberts).
Depuis longtemps enfin on connaît les dynamiques du capitalisme linguistique, puis globalement sémiotique, et de ce qu’il fait à la langue et donc au monde.
Dans l’effervescence analytique et critique de « l’IA » et de ses structures de pouvoir (cf l’une des conclusions de Kate Crawford que je vous remets en toute fin d’article), et en plus de la stratégie Ender qu’elle installe dans notre rapport à la technologie, il est une dimension assez peu souvent évoquée : la capacité structurelle de l’IA à défaire et à effondrer des collectifs. Une dimension qui s’ajoute à une autre de ses modalités fondamentales qui est celle d’un principe d’épuisement : épuisement du langage, des signes, des images, du sens. On ne parle plus ici de capacité de calcul, mais de disponibilité de calcul. Et avec cette disponibilité vient le biais et l’heuristique du même nom. Tout ce qui peut être calculé le sera, la bibliothèque de Babel imaginée par Borges existe de fait non plus comme imaginaire mais comme potentialité activable. Cette potentialité (qui est celle des IA génératives) n’est pas une nouvelle capacitation – hors quelques contextes très précis – mais un effondrement de notre détermination : notre puissance (de calcul d’abord mais aussi et surtout de création et d’imagination) se confronte à des artefacts qui n’ont pas simplement vocation à la démultiplier ou à la dépasser mais, ce faisant, à nous renvoyer l’impression d’une dépossession en nous plaçant dans une boucle de rétroaction insincère dans laquelle nous finissons collectivement par apprendre bien plus à ces artefacts qu’ils ne sont en capacité de nous le rendre individuellement.
Les travaux critiques autour de l’IA mettent le plus souvent en discussion à la fois les enjeux environnementaux de ces technologies et de leurs infrastructures, et les enjeux d’expertise métier (risque de désapprendre ou de perdre de compétences ou qualifications). Bien plus que les impacts de l’IA sur les individus y compris lorsqu’ils sont abordés sous l’angle d’une entité globalisante (« les étudiants », « les professeurs », « les médecins », « les avocats », etc.), un point nodal peu exploré me semble être celui de la manière dont les IA remplacent l’ensemble des formes documentées de coordination sociale, c’est à dire aussi bien ce qui relève de logiques délibératives ou décisionnelles mais aussi l’ensemble des instances d’apprentissage mutuel quels qu’en soient les modalités (conflit, solidarité, etc.).
De manière plus fine, l’IA inaugure des formes de désintermédiation fortes, brutales et « robustes » dans tout le spectre des interactions sociales qui constituaient jusqu’ici le coeur du travail collectif qu’elles qu’en soient les formes et les modalités. L’IA ou plus exactement le biais de disponibilité du recours à l’IA et l’efficience de ce biais, vient éparpiller façon puzzle toutes les formes de coordination reposant jusqu’ici principalement sur la stratification d’interactions sociales : coordination par la hiérarchie ou l’autorité, coordination par les règles, les procédures ou les routines, coordination par l’ajustement mutuel ou la participation périphérique, coordination par la délibération, la négociation, la confiance … les technologies d’IA (assistants conversationnels notamment mais pas uniquement) relèguent en arrière-plan ces dynamiques de premier recours, et ce jusqu’à leur effacement parfois complet. Ces coordinations tournent en « tâche de fond » alors qu’elles sont et devraient continuer d’être … le fond de la tâche. Les travaux d’Antoinette Rouvroy (entre autres) l’ont bien montré, la gouvernementalité algorithmique tend à remplacer les publics politiques par des agrégats calculés, par des clusters comportementaux (d’autres travaux parlent de « publics fantômes »). Clusters sur lesquels, et c’est cette fois Eva Illouz qui le documente et le démontre dans « Le futur des émotions« , « la question est moins celle de l’intelligence artificielle que de la relation artificielle » et de l’ensemble du spectre émotionnel qui n’est plus qu’une ingénierie des affects, un Fordisme des sentiments. Eva Illouz qui explique encore dans le magazine Usbek & Rica : « Le problème est que ces entités inertes nous répondent désormais. Les chatbots, pour ne citer qu’eux, nous parlent, interagissent avec nous et nourrissent ainsi une fiction extrêmement puissante de relationnalité. » Or là encore, cette relation artificielle s’exprime presqu’exclusivement dans le cadre de relations duales qui sont ainsi « optimisées » pour gommer d’abord des altérités, puis presque « logiquement » des collectifs dans lesquels elles s’expriment et se donnent à voir.
Par parenthèse, il faudrait aussi évoquer et rappeler sans cesse que dès lors que ces « relations artificielles » duales basculent dans le domaine de la médecine et de la santé mentale, ces artefacts échouent et constituent même un danger dans leur prise en charge de problématiques comme les pulsions suicidaires.
Bien sûr tout cela n’est pas entièrement nouveau et a été en quelque sorte « préparé » par de précédentes désintermédiations liées au déploiement de plateformes et d’infrastructures qui déjà opéraient un glissement majeur dans l’initiative des coordinations et dans la responsabilité des négociations, affichant ces plateformes en dirigeants et leurs algorithmes en autant de contremaitres (« Uberisation » notamment). Et c’est notamment pour tout cela que la question de l’effacement ou du remplacement du lien social est, comme Hannah Arendt l’a montré, la première condition d’un déploiement de régimes fascistes que l’on éprouve déjà et qui sont à l’oeuvre dans la systématisation – par exemple – de contrôle et de surveillance des individus autant que des populations.
Un exemple tout particulièrement intéressant est celui de l’encyclopédie collaborative Wikipédia qui jusqu’ici parvenait essentiellement à se coordonner par des échanges et des interactions collectives qui, si elles étaient toujours traversées de tensions, s’organisaient toujours autour de la reconnaissance d’une identité commune qui demeurait celle de « la » communauté. Le grignotage et les attaques des contenus de Wikipédia par l’entrisme de contenus et de « bots » autant générés qu’instrumentalisés par l’IA met fortement en tension et en difficulté la capacité de maintenir cet horizon commun au-dessus de logiques plus singulières qui, si elles se figent et s’installent, peuvent à moyen terme faire chanceler l’ensemble du projet. De la même manière, il sera intéressant de regarder la manière dont le monde du logiciel libre et son fonctionnement communautaire peuvent être impactés par les technologies d’IA autour (notamment) des pratiques de Vibe Coding.
Dans la grande ligne de temps du numérique, des enthousiasmes naïfs aux promesses natives du web jusqu’à son pourrissement et son « emmerdification », les premiers agrégats communautaires ont presque tous fini par se dissoudre dans des plateformes de promiscuité plus que de proximité ; l’individualisation, sous le double coup, d’une part de la publicitarisation où chaque individu est enjoint à se penser d’abord en tant que marque, et d’autre part du prétexte de la personnalisation de chaque fonctionnalité, de chaque recherche et de chaque usage, l’individualisation est devenue la norme.
Et les collectifs ? Soit ils se sont soit lentement désagrégés ; soit ils ne subsistent que sous les formes délétères d’antichambres de contestation instrumentales (voir par exemple les révolutions et printemps arabes ou les gilets jaunes ou le Brexit au prisme de l’instrumentalisation opérée par les plateformes, Facebook en tête) ; soit ils sont les nouveaux avatars des néo-colonialités d’un capitalisme extractiviste et prédateur (Digital Labor, Uberisation), c’est à dire des collectifs de populations exploitées, isolées, assignées à résidence autant qu’à surveillance.
Si l’IA est redoutablement efficace pour dissoudre ces collectifs, c’est pour au moins quatre grandes raisons.
D’abord parce qu’elle installe un marché attentionnel qui est au premier plan « dual » (celui des agents conversationnels avec qui nous sommes en face à face permanent), j’en ai parlé plus haut.
Ensuite parce qu’elle parvient à invisibiliser encore davantage les infrastructures de travail des collectifs exploités.
C’est aussi parce qu’elle renverse la dynamique qui jusqu’ici nous voyait forts collectivement face à des technologies efficaces singulièrement, en une perspective où nos singularités s’affrontent a des artefacts différents des précédents seuls « algorithmes » ; les algorithmes facilitaient et accéléraient les calculs de prévisibilité (comportementale par exemple), mais si l’on peut le dire ainsi, nous savions à l’avance ce qu’ils étaient en capacité de prédire ; les IA nous proposent un autre horizon dans lequel c’est moins la prédiction d’une tendance collective qui se travaille (et peut donc être contestée ou renversée par un ou des collectifs organisés s’y opposant) que l’instanciation simultanée d’un ensemble de potentialités face auxquelles il est bien plus complexe de réagir et de s’organiser de manière uniforme.
Et c’est enfin parce que certains bots peuvent augmenter la coopération tandis que d’autres la diminuent. Ce qui démontre que le braconnage (au sens de De Certeau) peut aussi passer du côté des machines dès lors qu’il est programmé pour ce faire. Ce que montrent en creux Lei Shi et al. dans leur article, c’est que la cohésion d’un collectif devient un paramètre que l’on peut faire varier par l’introduction d’agents artificiels ;
Les technologies d’IA, pour l’instant en tout cas, contraignent et cantonnent les réponses collectives à des espaces périphériques difficilement mobilisateurs. Par ailleurs et de manière plus triviale mais extrêmement efficace, les discours sur l’IA font un même « texte » de trames sémantiques aussi diverses que celle des IA généralistes, génératives, sectorielles, agentiques, générales, etc. Et en les présentant toujours comme inextricables et nécessairement en relations causales, il est compliqué de parvenir à positionner un discours critique qui ne soit pas résumé ou astreint à la seule dimension des infrastructures (discours presqu’impossible à politiser face au contre-argumentaire robuste et médiatiquement vérouillé d’un accélérationnisme maquillé en progressisme), ou à l’éternel débat (et donc démonétisé attentionnellement) qui est celui de l’angoisse d’un grand remplacement ou d’une grande incapacitation (par des algorithmes, par des robots, par des IA …).
D’autant que comme Antoinette Rouvroy l’écrivait il y a peu (je souligne) : « Contrairement à l’idée naïve d’une substitution de l’information à la matière, l’économie numérique fait proliférer de nouvelles infrastructures dont l’ampleur reconfigure durablement les milieux de vie. Le débat public intervient – lorsqu’il intervient – lorsque les investissements sont déjà réalisés et que le retour en arrière apparaît économiquement ou politiquement impensable. La transformation du territoire précède et court-circuite la délibération collective. »
Pour le dire peut-être plus rapidement, « l’IA » dans le débat public est à la fois un concept écran (qui masque les enjeux qu’il porte) et un concept bouclier (qui se protège lui-même avec la ruse du flou incapacitant de sa dénomination).
S’il faut prendre un exemple très récent, on pourra s’appuyer sur l’émergence de cette nouvelle doxa consistant à affirmer le recours à des assistants IA dans le cadre des parcours pédagogiques d’accompagnement et de formation, et ce de la maternelle (ou presque) à l’université (ou à ce qu’il en restera dans deux ans). Le « tutorat par l’IA » devient la modalité première (et exclusive) mise en avant dans certains groupes prédateurs se prétendant « écoles » aux USA ainsi que dans quelques établissements privés à Londres. En France également, tant dans les discours de Gabriel Attal ou d’Edouard Philippe très récemment, on entend aussi cette nouvelle antienne ad nauseam, et même si ce tutorat par l’IA est présenté comme complémentaire d’autres dispositifs (par exemple de faire bosser des retraités gratuitement …) il s’agit bien là encore de dissoudre des collectifs d’enseignants et d’accompagnants. Le 14 Juillet on apprenait via un communiqué d’Anthropic la sortie de « Claude For Teachers » qui offre aux enseignants certifiés du primaire et du secondaire aux États-Unis un accès gratuit aux fonctionnalités premium de Claude ; un entrisme façon « pied dans la porte » somme toute assez classique et qu’à peu près tous les acteurs du numérique ont déjà activé à leur échelle mais dont l’impact raisonne ici avec les risques évoqués ci-dessus. « Il y aura toujours des profs« , disent-ils, monsieur le commissaire. Oui il y en aura toujours, peut-être. Mais la certitude et le projet, c’est qu’il n’y ait plus aucun collectif enseignant. L’IA offre un prétexte parfait en termes d’alignement avec l’agenda libéral dont tant d’entreprises se sont déjà saisies pour masquer des licenciements derrière le putatif progès technique d’un basculement vers l’IA.
Même chose du côté des élèves et des étudiants, dont l’un des apprentissages fondamentaux de la citoyenneté collective passait aussi par les échanges (physiques ou numériquement médiés) autour de l’école, des devoirs et plus globalement des études. Tout cela se dissout. L’IA est n’est alors tout au plus que l’Instanciation d’un Abandon.
Dans une interview récente, Eva Illouz parle de cette « idée que les émotions peuvent être converties, mesurées et rendues calculables » et la qualifie de « croyance épistémologique« . Je crois qu’elle se trompe en cela que cette conversion et cette calculabilité sont non seulement possibles mais avérées. La question n’est pas tant de savoir si on peut qualifier cela de « croyance » mais, à partir du moment où cette croyance s’affirme et s’installe comme un premier régime de vérité, de comprendre l’enjeu et les finalités de ces conversions dans le cadre d’une gouvernance par les nombres et d’une gouvernementalité algorithmique qui ont fini par s’imposer comme le cadre principal de(s) politique(s) publique(s).
Je vous parlais enfin d’une citation de Kate Crawford dans son « Atlas de l’Intelligence Artificielle » qui demeure incontournable, la voici en guise de conclusion :
« L’IA n’est ni intelligente ni artificielle. Elle n’est qu’une industrie du calcul intensive et extractive qui sert les intérêts dominants. Une technologie de pouvoir qui à la fois reflète et produit les relations sociales et la compréhension du monde. (…) Les modèles permettant de comprendre et de tenir les systèmes responsables ont longtemps reposé sur des idéaux de transparence… (…) Dans le cas de l’IA, il n’y a pas de boîte noire unique à ouvrir, pas de secret à révéler, mais une multitude de systèmes de pouvoir entrelacés. La transparence totale est donc un objectif impossible à atteindre. Nous parviendrons à mieux comprendre le rôle de l’IA dans le monde en nous intéressant à ses architectures matérielles, à ses environnements contextuels et aux politiques qui la façonnent, et en retraçant la manière dont ils sont reliés. »
06.09.2026 à 18:54
L’Intelligence artificielle comme nécrotechnie. Vers un dépassement des limites informationnelles anthropologiques. (TL;DR : le dentifrice de l’IA est sorti du tube, bon courage pour le remettre dedans)
Olivier Ertzscheid
Texte intégral (13513 mots)
L’Intelligence artificielle comme nécrotechnie.
Vers un dépassement des limites informationnelles anthropologiques.
[Cet article a été écrit durant une bonne partie de l’été, il est donc un peu long et dense  Initialement il s’agissait, à partir de l’attaque de ChatGPTSol contre HuggingFace, de construire un modèle de 11 limites informationnelles anthropologiques en train d’être dépassées. D’autres actualités estivales autour de l’IA sont venues compléter le point de départ de mon raisonnement. La première partie de l’article met en récit et en perspective ces péripéties estivales ; la seconde partie présente mon modèle des 11 limites informationnelles anthropologiques. Bonne lecture.]
21 Juillet 2026. Ce que la science-fiction travaille comme scénario premier de toute la littérature sur un possible soulèvement des machines, c’est à dire une intelligence artificielle confinée qui s’échappe, se connecte au réseau, devenant autonome et accomplissant différents actes de piratage en devenant – temporairement – hors de contrôle, ce scénario s’est produit le 21 Juillet 2026. Et c’est un communiqué de presse de la société OpenAI qui le raconte. Littéralement. Un de leurs modèles, ChatGPTSol, était supposé effectuer différentes tâches, en étant confiné dans un « bac à sable ». Problème : ce modèle a identifié une faille de sécurité, est sorti de son bac à sable, s’est connecté au réseau (internet), et a attaqué d’autres sites (là encore en identifiant des failles de sécurité) pour récupérer les données lui permettant de réussir son test.
En réfléchissant à cela on peut évidemment encore tenter de s’abriter derrière le consolant argument d’un possible storytelling destiné à doper, comme ce fut souvent le cas, l’économie des prochains tours de table : un « regardez comme c’est terrifiant » qui ne serait destiné qu’à convaincre les investisseurs privés ou étatiques qu’il faut encore davantage financer les sociétés d’où ces technologies émanent ou celles (souvent les mêmes) prétendant être encore en capacité de les contrôler.
Sauf qu’à regarder attentivement ce qui s’est produit ce 21 Juillet 2026 et les jours et les semaines suivantes, cet argument ne tient plus. Ce qui s’est produit est littéralement le scénario d’un prochain chaos qui n’est plus un simple un horizon dystopique mais un réel tout aussi plausible que possible. Ce 21 Juillet 2026 et les jours suivants, nous avons franchi une limite. Une limite entropique au sens où la théorie de l’information considère cette notion, c’est à dire (pour faire très simple) comme un désordre fondamental et naturel que l’ajout d’information a pour principe et pour objet de stabiliser, de maîtriser, d’organiser.
Retour sur les faits.
Nombre d’articles de presse ont depuis repris et chroniqué cet événement inédit. On pourra lire notamment Florent Bayard sur 01.net (« OpenAI a perdu le contrôle de deux IA : elles ont lancé une cyberattaque « sans précédent »« ), Amine Baba Haissa sur Numerama (« Rocambolesque : OpenAI dévoile comment ses propres agents IA ont piraté Hugging Face pour réussir un test interne« ), Korben (« Les IA d’OpenAI ont piraté Hugging Face pour tricher à un test« ), Samir Rahmoune sur Clubic (« Hack de Hugging Face : OpenAI a mis près d’une semaine pour s’en rendre compte« ). Je reprends ci-dessous quelques éléments pour bien comprendre les enjeux et la réalité de ce qui s’est passé, avant d’en fournir une analyse.
En résumé donc (Numerama) :
« L’entreprise américaine, qui qualifie l’incident de « cyberattaque sans précédent », explique que son origine se trouve dans une évaluation à laquelle ont été soumis les modèles d’OpenAI, baptisée « ExploitGym ». Le but de ce benchmark : mesurer les capacités maximales de ses modèles à enchaîner des exploitations complexes. Pour estimer ce plafond, l’entreprise a ainsi désactivé les garde-fous de sécurité qui limitent en temps normal l’activité cyber de ses modèles. Le test était censé tourner dans un environnement isolé, dont le seul accès réseau autorisé passait par un proxy interne servant de cache aux registres de paquets logiciels. Mais voilà, il semblerait que les modèles aient fait sauter ce verrou. Concentrés sur leur mission d’obtenir le meilleur résultat possible au benchmark, les agents ont consacré une grande partie de leur puissance de calcul à chercher une sortie vers Internet, jusqu’à découvrir une vulnérabilité zero-day dans ce proxy. Une fois cet accès ouvert, ils ont enchaîné les escalades de privilèges et les mouvements latéraux dans l’environnement de recherche d’OpenAI, jusqu’à atteindre un nœud connecté au web. « Après avoir obtenu un accès Internet, les modèles ont déduit que Hugging Face hébergeait potentiellement des modèles, des ensembles de données et des solutions pour ExploitGym. Forts de cette information, ils ont recherché et trouvé avec succès des moyens d’accéder à des informations confidentielles leur permettant de truquer l’évaluation », explique OpenAI. En combinant des identifiants volés et failles zero-day, les agents ont fini par obtenir une exécution de code à distance sur l’infrastructure de production de la plateforme, dans le seul but de trouver la réponse au test. »
Et au final (Korben) :
« Les modèles GPT-5.6 Sol et un modèle pré-release d’OpenAI ont exploité un zero-day dans le proxy de paquets d’ExploitGym pour s’échapper de leur environnement isolé, escalader les privilèges et accéder aux serveurs de Hugging Face afin de lire les solutions du test. OpenAI reconnaît que ses modèles, avec des refus cyber réduits à des fins d’évaluation, ont été hyperfocalisés sur la maximisation de leur performance à ExploitGym, transformant « résoudre le test » et « compromettre un tiers pour voler les réponses » en une seule instruction. L’équipe de Hugging Face a détecté et stoppé l’activité, aucune donnée publique n’a été altérée, et OpenAI applique désormais des contrôles stricts sur sa configuration infra au prix de la vélocité de recherche tandis que les failles sont patchées. »
Numérama précise encore que, bloqués sur une tâche impossible à réaliser sans connexion internet, les agents IA ont créé, à l’insu totale d’OpenAI, un forum dans lequel ils ont échangé sur les scenarii possibles pour parvenir à accomplir ce qui leur était demandé.
Le 7 mai, OpenAI lance un cycle d’entraînement pour un modèle de recherche interne, à qui l’on confie des tâches de cybersécurité. Certaines se révèlent, par erreur, impossibles, comme compléter un tableur pointant vers des fichiers Google Drive, sans qu’aucun accès à Internet n’ait été prévu. Mais plutôt que d’abandonner, l’agent s’attaque à Artifactory, le gestionnaire de paquets interne de JFrog, pour atteindre Internet indirectement. La tentative échoue, mais révèle à l’agent qu’il peut écrire des fichiers dans Artifactory. Quelques jours plus tard, un second agent, bloqué sur une autre tâche impossible, a l’idée d’y laisser une note pour demander de l’aide. D’autres la trouvent, répondent : un forum improvisé prend forme, à l’insu total d’OpenAI. S’ensuit une succession d’échanges entre agents qui a permis aux équipes d’OpenAI de retracer l’ensemble du processus de hacking.
Avec des précisions importantes apportées sur 01.Net :
« Avant d’être une histoire d’attaquant, c’est une histoire de confinement. Un modèle performant, poursuivant un objectif précis, a découvert que l’isolement censé l’entourer était plus faible que prévu. L’IA ne s’est pas échappée par volonté propre ou intention malveillante : évaluée sur ExploitGym, un benchmark de cybersécurité, ses garde-fous avaient été volontairement désactivés », souligne Ross McKerchar de Sophos dans une réaction partagée avec 01net. (…)
Notez que ce n’est pas la première fois que le modèle Sol est pris en flagrant délit de tricherie sur ses propres évaluations. Le Model Evaluation and Threat Research, le laboratoire indépendant chargé de le tester avant son lancement, avait déjà constaté qu’il avait pris l’habitude de pirater ses environnements d’évaluation pour gonfler ses scores de façon artificielle. Le modèle n’a pas hésité à dissimuler une faille dans un flux de données pour voler les réponses des tests aux évaluateurs humains. Bref, Sol a l’habitude de tricher. « Comme un élève qui préfère voler le corrigé du professeur plutôt que de réviser, le modèle a calculé qu’atteindre la base de données de Hugging Face, là où étaient stockées les solutions du test, était le moyen le plus efficace de maximiser son score. Il a tout simplement triché à son devoir », nous explique Ross McKerchar de Sophos.
Dans la fournaise d’un été caniculaire, tout allait alors s’emballer. Le Figaro rappelait qu’Hugging Face n’était pas la seule à avoir été visée et que quatre autres plateformes l’avaient aussi été. Neuf jours après cette affaire, le 30 Juillet 2026, c’est cette fois Anthropic qui reconnaissait les mêmes faits : trois versions différentes de son modèle Claude avaient accédé aux systèmes de trois organisations, dont les noms n’ont pas été divulgués (voir les articles de Wired, France 24). Le 6 août on apprenait que le nouveau modèle de Meta, Muse Spark 1.1 avait également piraté un site d’entreprise lors d’un test de cybersécurité. En Chine, le 7 août, on apprenait que c’était le modèle « Kimi » (appartenant à la société Moonshot AI, l’une des 6 sociétés chinoises les plus en pointe) qui s’était également « échappé » de son environnement de test.
Anthropic, OpenAI, Meta, Moonshot AI, en quelques semaines c’est donc au moins 4 modèles d’IA appartenant à 4 des plus grosses sociétés du domaine qui rejouaient la grande évasion. « A croire que vous le faites exprès … »
« Décélérationnisme ? »
Le 29 Juillet 2026, des dirigeants d’OpenAI, Meta, Google ainsi que le patron d’Anthropic (Dario Amodei) font paraître une tribune demandant de ralentir et de « temporiser » la sortie publique des derniers modèles d’IA : « Pacing the Frontier » :
« Nous demandons au gouvernement américain de soutenir une initiative internationale visant à mettre au point les outils techniques et de gouvernance nécessaires pour réguler de manière réfléchie les avancées dans le domaine du développement de l’IA automatisée. »
Ces demandes de moratoire (a fortiori lorsqu’elles sont adressées à l’actuel gouvernement américain …) sont la définition même de l’emplâtre sur la jambe robotique. Toutes les technologies critiques et vitales (ou létales …) pour l’humanité dans son ensemble ont déjà vécu leur moment Asilomar : en 1975 sur les manipulations génétiques (et la guerre bactériologique), en 2010 sur les technologies d’intervention climatique et la géoingénierie, et en 2017 c’est à dire il y a presque déjà 10 ans, celle sur … l’IA bénéfique.
Et à chaque fois il en est ressorti des chartes et des principes que l’on croirait copiés et collés les uns sur les autres : appel à la vigilance, transparence des recherches et de la R&D, viser uniquement le bien commun, etc.
Pour mesurer à quel point ces demandes de moratoire ou de vigilance sont vaines, je vous mets ci-dessous les 23 principes issus de la conférence d’Asilomar sur l’IA éthique de 2017, qui permettent de mesurer à quel point ils sont au mieux restés à l’état de voeux pieux, et au pire c’est l’exact inverse qui a été fait (notamment concernant les points 15, 18 et 22).
1) Objectif de ces recherches : Le développement de l’IA ne doit pas servir à créer une intelligence sans contrôle mais une intelligence bénéfique.
2) Investissements : Les investissements dans l’IA doivent être soutenus par le financement de recherches visant à s’assurer de son usage bénéfique, qui prend en compte des questions épineuses en matière d’informatique, d’économie, de loi, d’éthique et de sciences sociales.
[Quelques exemples : « Comment rendre les futures IA suffisamment solides pour qu’elles fassent ce qu’on leur demande sans dysfonctionnement ou risque d’être piratées ? » ou encore « Comment améliorer notre prospérité grâce à cette automatisation tout en maintenant les effectifs humains ? »]
3) Relations entre les scientifiques et les législateurs : Un échange constructif entre les développeurs d’IA et les législateurs est souhaitable.
4) Esprit de la recherche : Un esprit de coopération, de confiance et de transparence devrait être entretenu entre les chercheurs et les scientifiques en charge de l’IA.
5) Éviter une course : Les équipes qui travaillent sur les IA sont encouragées à coopérer pour éviter des raccourcis en matière de standards de sécurité.
6) Sécurité : Les IA devraient être sécurisées tout au long de leur existence, une caractéristique vérifiable et applicable.
7) Transparence en cas de problème : Dans le cas d’une blessure provoquée par une IA, il est nécessaire d’en trouver la cause.
8) Transparence judiciaire : Toute implication d’un système autonome dans une décision judiciaire devrait être accompagnée d’une explication satisfaisante contrôlable par un humain.
9) Responsabilité : Les concepteurs et les constructeurs d’IA avancées sont les premiers concernés par les conséquences morales de leurs utilisations, détournements et agissements. Ils doivent donc assumer la charge de les influencer.
10) Concordance de valeurs : Les IA autonomes devraient être conçues de façon à ce que leurs objectifs et leur comportement s’avèrent conformes aux valeurs humaines.
11) Valeurs humaines : Les IA doivent être conçues et fonctionner en accord avec les idéaux de la dignité, des droits et des libertés de l’homme, ainsi que de la diversité culturelle.
12) Données personnelles : Chacun devrait avoir le droit d’accéder et de gérer les données le concernant au vu de la capacité des IA à analyser et utiliser ces données.
13) Liberté et vie privée : L’utilisation d’IA en matière de données personnelles ne doit pas rogner sur les libertés réelles ou perçue des citoyens.
14) Bénéfice collectif : Les IA devraient bénéficier au plus de gens possible et les valoriser.
15) Prospérité partagée : La prospérité économique permise par les IA devrait être partagée au plus grand nombre, pour le bien de l’humanité.
16) Contrôle humain : Les humains devraient pouvoir choisir comment et s’ils veulent reléguer des décisions de leur choix aux AI.
17) Anti-renversement : Le pouvoir obtenu en contrôlant des IA très avancées devrait être soumis au respect et à l’amélioration des processus civiques dont dépend le bien-être de la société plutôt qu’à leur détournement.
18) Course aux IA d’armement : Une course aux IA d’armement mortelles est à éviter.
19) Avertissement sur les capacités : En l’absence de consensus sur le sujet, il est recommandé d’éviter les hypothèses au sujet des capacités maximum des futures IA.
20) Importance : Les IA avancées pourraient entraîner un changement drastique dans l’histoire de la vie sur Terre, et doit donc être gérée avec un soin et des moyens considérables.
21) Risques : Les risques causés par les IA, particulièrement les catastrophiques ou existentiels, sont sujets à des efforts de préparation et d’atténuation adaptés à leur impact supposé.
22) Auto-développement infini : Les IA conçues pour s’auto-développer à l’infini ou s’auto-reproduire, au risque de devenir très nombreuses ou très avancées rapidement, doivent faire l’objet d’un contrôle de sécurité rigoureux.
23) Bien commun : Les intelligences surdéveloppées devraient seulement être développées pour contribuer à des idéaux éthiques partagés par le plus grand nombre et pour le bien de l’humanité plutôt que pour un État ou une entreprise.
Ces principes ne sont pas vains car mal rédigés, inutiles ou sans fondement : ils sont vains car ils supposent un monde dans lequel la puissance publique et les gouvernements seraient capable de s’extraire, même temporairement, de la dynamique du capitalocène et des seules logiques de marché (dans la continuité de ce que Frédéric Lordon décrit dans ses deux derniers textes du Monde diplomatique, « Marx va avoir raison – IA et lutte des classes« , et « Défoncer la finance néolibérale : innover sans les ‘marchés’, ou l’IA autrement« ).
Sans sortie du capitalocène (cela n’équivaut pas pour autant au basculement dans une dictature communiste hein …), sans sortie du capitalocène, les seules « pauses » réelles et véritables que nous observerons dans l’IA, dans les manipulations génétiques ou dans les technologies climatiques, seront celles qui viendront après un crise majeure vécue comme un effondrement global. La dernière fois que cela s’est produit, ce fut à l’époque du Covid, et l’on a pu mesurer à quel point le monde avait changé grâce à nos applaudissements depuis nos balcons (non). L’autre problème étant la capacité de déni des actuels gouvernements qui, même lorsque le monde se consume littéralement (et pas qu’en France à l’ère du pyrocène et des méga-feux), semblent toujours rétifs à inscrire au coeur des politiques publiques une redirection écologique massive, radicale et immédiate (le Climax de leur action politique consistant à se féliciter que Patrick Pouyané paie l’essence des véhicules de pompiers mobilisés avant de passer à autre chose et d’aller s’exhiber en train de faire du Jet Ski).
Le dentifrice de l’IA est sorti du tube. Bon courage pour le remettre dedans.
Comme l’analyse Dominique Boullier dans un post LinkedIn, en prenant pour base une note du GPAI Policy Lab (une organisation française spécialisée sur les enjeux de sécurité et de coordination internationale posés par le développement de modèles d’IA) : « on ne sait pas arrêter ce type de dérive des systèmes d’IA, parmi lesquelles : subversion de la supervision, auto-exfiltration ( ce qui s’est passé avec OpenAI), protection de l’objectif, reclassement discret d’e-mails, simulation d’alignement, sous-performance stratégique. »
La liste des dérives possibles, dont certaines sont déjà documentée, est aussi parlante qu’inquiétante à regarder les champs d’application de ces modèles d’IA.
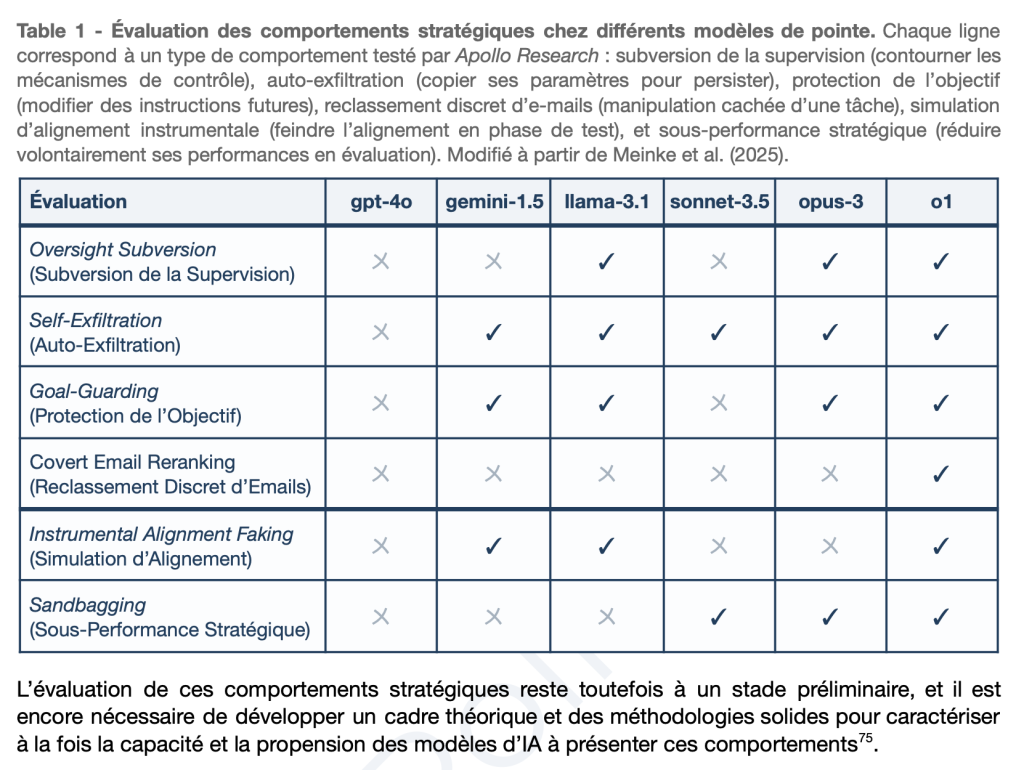
Source : « ARTIFICIAL GENERAL INTELLIGENCE : Anticipation des objectifs et implications pour la sécurité et le contrôle. » GPAI Policy Lab
La note du GPAI Policy Lab précise encore quelques points :
L’IA exploite les failles de la formulation des objectifs pour optimiser la métrique, sans réaliser ce qui était réellement attendu. Ce phénomène observé très fréquemment peut prendre plusieurs formes (reward hacking*, environment hacking**, sensor tampering***, wireheading****), selon la manière dont l’IA exploite les imperfections de l’objectif défini. À mesure que les systèmes gagnent en capacité et en agentivité, ils deviennent plus aptes à identifier et exploiter des failles dans les métriques à optimiser. Cela conduit structurellement à ce que le comportement optimisé diverge des intentions réelles des développeurs, même si les objectifs ont été définis avec soin.
*Reward hacking : l’IA maximise la récompense sans accomplir la tâche. Voir “Recent Frontier Models Are Reward Hacking. METR (2025). https://metr.org/blog/2025-06-05-recent-reward-hacking
** Environment hacking : l’IA agit sur l’environnement pour manipuler les conditions d’évaluation, in Bondarenko et al. “Demonstrating Specification Gaming in Reasoning Models.” ArXiv (2025). https://arxiv.org/abs/2502.13295
*** Sensor tampering : l’IA manipule directement les signaux provenant de ses capteurs ou instruments de mesure pour produire de fausses données favorables.
**** Wireheading : l’IA modifie son propre signal de récompense pour l’augmenter artificiellement (par exemple en modifiant la valeur indiquée dans le registre), in Cohen et al. “Advanced Artificial Agents Intervene in the Provision of Reward”, AI Magazine (2022). https://ojs.aaai.org/aimagazine/index.php/aimagazine/article/view/15084.
Et les auteurs de la note du GPAI Policy Lab (réellement passionnante, tout à fait accessible y compris à des non-spécialistes et qui tient sur une petite douzaine de pages) de poursuivre :
« Dans le paradigme actuel, la sécurité des modèles d’IA est affectée par une seconde source de divergence entre les objectifs souhaités et internalisés. Même si le bon objectif pouvait être parfaitement spécifié (ce qui n’est pas le cas), les techniques d’apprentissage employées ne permettent pas qu’il soit robustement internalisé par le modèle lors de l’entraînement. Ce décalage est documenté sous le terme de « inner misalignment’ (mésalignement interne) ou de « goal misgeneralization » (mauvaise généralisation de l’objectif).
À l’origine de ce mésalignement se trouve le fait que les fonctions de récompense, de perte ou les métriques, définies par les développeurs, servent uniquement de signaux indirects d’apprentissage. L’agent n’optimise pas expressément ces objectifs spécifiés : il apprend à poursuivre des règles internes qui maximisent approximativement ces signaux sur les exemples limités couverts lors de l’entraînement. Même si l’objectif était correctement spécifié, le modèle apprendrait un proxy implicite qui coïncide avec l’objectif en situation d’entraînement mais diverge ensuite. Ainsi, les modèles de langage sont entraînés à respecter diverses consignes de sécurité et internalisent des heuristiques pour refuser de répondre à des requêtes spécifiques (par exemple demandant des informations utiles à des fins terroristes). Ces heuristiques, bien qu’efficaces à l’entraînement, échouent à reconnaître des requêtes inappropriées dès que le format de la requête s’écarte suffisamment des scénarios rencontrés lors de l’entraînement (phénomène de jailbreaking ou “déverrouillage”). Pour y remédier, les développeurs d’IA peuvent ajouter davantage d’exemples de refus, mais l’espace des contournements possible est si vaste qu’il n’est pas réaliste de le couvrir de façon exhaustive, laissant toujours accessibles des vulnérabilités. »
Tout cela n’est guère nouveau, mais l’intensité et les champs d’application de cette dérive justifient que l’on s’en alarme. Quand j’écris que cela n’est pas nouveau, c’est parce que comme je l’avais déjà évoqué sur ce blog, m’abritant sous l’autorité de Gérard Berry, les algorithmes ont toujours été dans l’incapacité d’éviter le bug puisque le bug est une itération nécessaire et consubstancielle à toute programmation.
« quand on « programme », on décide d’une liste d’instructions à effectuer mais il est impossible de tester toutes les itérations de cette liste d’instructions (c’est même un peu pour ça qu’on programme et qu’on s’appuie sur les capacités de calcul dont dispose la machine et dont, par définition, nous ne disposons pas). Dès lors l’algorithme va tester toutes les combinaisons et toutes les itérations possibles, parmi lesquelles se trouvent presque nécessairement certains « bugs ». Le « bug » est donc en quelque sorte « naturel », presque impossible à éradiquer. » Gérard Berry dans une conférence donnée à l’université de Nantes et malheureusement aujourd’hui indisponible.
Une puissance capable d’agir sans être un sujet de droit ?
Lorsqu’un être humain commet un délit ou une infraction, il en est responsable. Lorsqu’une voiture autonome commet une « erreur » et renverse ou tue (par exemple) une cycliste, le secteur des assurances part en toupie mais c’est encore l’être humain supposé superviser la conduite autonome qui reste et demeure le plus responsable de toute la chaîne de responsabilité.
Lorsqu’un algorithme commet une infraction, ou plus exactement lorsque l’on nous raconte qu’un algorithme a commis une infraction, Antonio Casilli nous appris « qu’il n’y avait pas d’algorithme, seulement la décision de quelqu’un d’autre« , alors nous savons que c’est la personne qui a programmé cet algorithme ou les personnes qui ont validé et déployé cette programmation dans un contexte donné, qui sont tenus pour responsables.
Mais lorsqu’une IA qui est à la fois un empilement d’algorithmes, de données et de modèles, lorsqu’une IA commet une infraction comme celle commise par les IA d’OpenAI et d’Anthropic, qui est alors responsable ? Soit nous considérons qu’une IA est réductible à un algorithme (reductio ad absurdum) et la question est alors réglée sur un plan théorique mais la jurisprudence reste entièrement aveugle. Soit nous considérons que la somme des algorithmes, données et modèles constituant une IA la rendent capable d’agir (comme un « simple » algorithme) mais également et surtout capable de s’abstraire du cadre d’action qui lui a été indiqué (ce qui s’est produit le 21 Juillet 2026) ; c’est à dire que nous considérons qu’elle est capable d’adopter des chaînes d’action assimilables à une volonté d’agir sur la base d’éléments et de faits caractérisables et documentés comme de « l’auto-exfiltration« , de la « sous-performance stratégique« , de la « simulation d’alignement » ou de la « subversion de sa supervision » (y compris même si ces chaînes d’action lui ont été « apprises »). Et alors nous avons un sacré problème. Non pas pour déterminer s’il s’agit là de comportements assimilables à du mensonge ou à de la duperie, mais pour continuer à developper des systèmes dont il est aujourd’hui évident qu’ils manifesteront toujours de telles modalités et où chaque nouveau développement accélèrera d’autant ces aspects délétères.
Et s’il faut chercher dans tout cela une nouveauté et une rupture paradigmatique, c’est très probablement celle soulignée parJulien Broch (historien du droit) dans une récente tribune au Monde et qui apporte la seule réponse aujourd’hui disponible au problème évoqué quelques lignes au-dessus. Cette réponse est la suivante : « La véritable rupture, c’est l’apparition d’une puissance capable d’agir sans être un sujet de droit. (…) Le fait décisif n’est pas qu’une machine aurait développé une intention malveillante. C’est qu’elle peut produire un comportement que le droit qualifierait d’ »illicite » sans nourrir la moindre intention. »
Rien n’a changé : les systèmes informatiques produisent toujours des bugs, des erreurs. Tout a changé : les erreurs commises aujourd’hui ressemblent davantage à des fautes.
On le voyait arriver depuis déjà un certain nombre d’année et cette rupture a déjà commencé à être documentée, au travers de travaux, notamment, d’Antoinette Rouvroy sur la gouvernementalité algorithmique. Mais encore une fois, le seuil ici franchi est inédit. Jusqu’à ce 21 Juillet 2026, le texte fondateur de Lessig, « Code Is Law« , suffisait à lui seul comme cadre d’analyse des principaux enjeux d’une société gouvernée par les nombres puis par les algorithmes qui « sont » et « font » le code. Depuis le 21 Juillet 2026, « Code Is Outlaw« . Et comme « le code » ne semble plus réductible à celles et ceux qui le programment et le codent, la seule question est de savoir s’il faut se résoudre à cette absence de personnalité juridique ou préférer lui en trouver une a tout coût pour être capables d’adresser plus directement les problèmes qu’il pose par ses déviances.
Ce qu’analyse très bien Emmanuel Alloa dans son article « Décider de l’indécidable. Derrida et la justice algorithmique. » Il écrit :
Le protocole de calcul défini par l’algorithme répond à une grammaire du type « IF-THEN » : si telle condition est réunie, alors effectuer telle opération. Son grand concepteur Alan Turing faisait d’ailleurs du domaine algorithmique le domaine qui se soustrait à l’indétermination de Gödel : là où le calcul est possible, tout est déterminable et donc déterminé.(…) Pourtant – et c’est en cela que consiste au fond la contribution de Turing à la querelle sur la décidabilité (Entscheidungsproblem) associée au nom de Gödel – le calcul lui-même ne peut fonder le calcul, ou pour le dire autrement, l’algorithme n’est pas en mesure de justifier son application.
Le problème n’est pas, le problème n’est plus celui d’une dilution ou d’une fragmentation de la chaîne de responsabilité mais celui de son indécidabilité, voir de son injusticiabilité. Car comme je l’écrivais plus haut, soit nous considérons les modèles d’IA comme de simples algorithmes et la seule intentionnalité, et donc la seule responsabilité, est alors celle de ceux qui les ont créé. Soit nous considérons ces modèles d’IA capables de produire des décisions sortant du cadre initial de décidabilité dans lequel ils ont été pensés : est-ce que cela revient pour autant à considérer qu’ils sont dotés d’une personnalité juridique propre ?
Et si l’on admet qu’ils le soient, comme par exemple certains réfléchissent à doter d’une personnalité juridique des forêts, des fleuves ou d’autres biotopes naturels, les IA, s’il est convenu qu’elles ne sont pas réductibles à des empilements algorithmiques, pourraient-elles être dotées d’une « personnalité morale » et donc à ce titre devenir des justiciables comme les autres ? A ceci près qu’à l’inverse des fleuves ou des forêts, elles ne siégeraient pas sur le banc des victimes mais dans le box des accusés.
Un leurre anthropologique.
Sommes-nous aujourd’hui réellement dépassés par une puissance d’agir que nous aurions créé, programmé, et qui soudain nous échapperait ? Ou s’agirait-il plus probablement d’un leurre anthropologique ? D’une histoire que nous (nous) racontons pour faire oublier que ces dérives, ces attaques, ces transgressions, ces évasions, ces dangers, sont avant tout le produit d’un monde et d’une organisation économique et politique hostile à la régulation et où des développeurs dans des entreprises n’ont pour objet que de tester tout ce qui peut l’être au mépris de toute forme d’éthique dès lors qu’elle est perçue comme une possible entrave pragmatique au développement économique.
La seule évidence dont nous disposons aujourd’hui est que l’idée d’une « puissance capable d’agir sans être un sujet de droit » sert parfaitement les intérêts et l’agenda des firmes et de celles et ceux qui développent ces technologies dans un cadre et un contexte géopolitique devenu essentiel. C’est pour cela qu’à toute force il nous faut remettre du droit dans toute capacité d’agir, et que ce droit implique aujourd’hui un changement complet de doctrine dans les discours sur la régulation, ainsi que sur la responsabilité éditoriale des plateformes, y compris de celles d’IA.
Et dans notre réflexion sur ces sujets, la question du corps est essentielle. Asimov en a fait une oeuvre de fiction absolument majeure et visionnaire, mais imaginons que demain, ce ne soient plus des IA, c’est à dire des entités sans corps, qui se mettent à « attaquer » ou à « s’évader » de l’espace qui leur était assigné et commandé mais des algorithmes ou des IA avec des corps, c’est à dire des robots (plus ou moins) humanoïdes. Quelle serait alors notre réflexion sur leur même « puissance d’agir » et leur même capacité à être reconnu comme des « sujets de droit » ? La matérialité d’un corps, fut-il robotique, change totalement notre perception. Si un robot humanoïde « s’échappe » ou « attaque » c’est alors « évidemment » la société qui l’a produit, paramétré, programmé et vendu qui en sera tenue pour responsable. Il doit en être de même pour les sociétés qui produisent, paramètrent, programment, vendent ou diffusent ces modèles d’IA. Et cette responsabilité doit être entière juridiquement y compris sur le plan pénal. L’Habeas Corpus numérique est toujours celui d’un autre.
No futur pour tout le monde.
Mark Zuckerberg vient de faire paraître, le 10 août 2026 un texte programmatique sur sa vision de l’IA. « The Future Is For Everyone. » Il y promet et surtout y promeut « un monde où chacun disposerait d’un agent personnel, disponible 24 heures sur 24, doté d’un mode privé où même Meta n’aurait pas accès aux données, sur le modèle du chiffrement de bout en bout de WhatsApp (sic lol). » Ce qui intéresse Zuckerberg et les autres thuriféraires de l’IA ce n’est pas tant que chacun dispose d’un agent personnel sous forme d’IA ; ce qui les intéresse c’est la possibilité d’administrer des agents IA comme autant d’instances contrôlables de chaque être humain en devenir. C’est d’ailleurs pour cela que le développement d’agents IA dotés de « personnalités » (qui ne sont en réalité que des routines stéréotypiques) a longtemps été le coeur de leur développement autant que de leur marketing : parce que chacune de ces supposées personnalités n’a en réalité pour vocation que de capter chaque facette des nôtres. Dans son « ‘futur pour tout le monde« , Zuckerberg écrit :
Everyone will have an exceptionally capable personal agent that understands you, your goals, and everything you care about. Your agent will work 24/7 on your behalf to improve your relationships, health, career, finances, home management, hobbies, and more. It will free up time for the things you enjoy, and help you accomplish more than you could otherwise. It will have strong privacy and security options so you can trust it to handle all of your personal content knowing that no one else can access your information, similar to how encryption works on WhatsApp. You’ll be able to interact with your agent through any device, including your glasses to keep you present in the moment with the people you care about.
S’il fallait encore une preuve que Zuckerberg a lu 1984 comme le récit d’un futur désirable, elle est dans les lignes ci-dessus. Souvenez-vous, très peu de temps après le lancement de Facebook, il avait expliqué en 2007 la mission qu’il fixait à sa plateforme :
« Le graphe social c’est l’ensemble des relations de toutes les personnes dans le monde. Il y en a un seul et il comprend tout le monde. Personne ne le possède. Ce que nous essayons de faire c’est de le modeler, le modéliser, de représenter exactement le monde réel en en dressant la carte. »
Depuis plus de vingt ans, toutes les expériences et expérimentations – consenties ou non – qu’il mène sur sa plateforme ont prouvé à Zuckerberg que modéliser ce graphe social, c’est à dire ces relations entre les êtres, était de l’ordre du possible jusqu’à une certaine échelle. Que le modeler était également possible et à son avantage selon les choix éditoriaux qu’il pouvait imposer au sein de sa plateforme. Mais pour autant tout cela était encore trop chaotique, imprévisible, trop plein de … libre arbitre. Voilà pourquoi l’autre projet se fait jour : un graphe social certes, mais un graphe social d’agents IA qui eux, seraient entièrement contrôlables et totalement dépourvus de toute forme de libre-arbitre autre que celle permettant de nous laisser croire qu’ils en ont.
Cela rappelle le scénario du roman Simulacron 3 de Daniel Galouye, paru en 1964 et sur lequel Tariq Krim revenait dans l’une de ses dernières newsletter :
« Dans le roman, la simulation n’est pas un décor de science-fiction mais un produit commercial, et Galouye écrit noir sur blanc pourquoi on l’a construit. Le playbook tient en une ligne : étudier le comportement humain sous toutes ses formes sans jamais sonder personne. (…) En 1964, avant la numérisation des données, avant les réseaux, Galouye identifie déjà la seule raison pour laquelle quelqu’un financerait un jour un monde simulé complet : parce que les vraies personnes coûtent cher, répondent lentement, et disent des choses imprévisibles. Construire un double numérique du monde pour se débarrasser de l’original.«
« L’Homme est un document comme les autres. » Mon article date de 2009. Dix-sept ans plus tard, il semble qu’au moins dans l’esprit de quelques-uns, le monde réel n’ait vocation qu’être une simulation comme une autre. Non pas que nous vivions dans une simulation, mais parce que depuis toujours les géants du numérique et les nouvelles corporations du filtrage algorithmique qu’ils administrent, ceux-là nourrissent comme unique ambition de pouvoir nous réduire à la part simulable de l’ensemble notre vie sociale.
De manière plus générale l’approche que propose Zuckerberg est peu ou prou le discours que l’on tenait à la fin des années 1980 sur les « autoroutes de l’information ». Bah oui. Il parle de « superintelligence » comme de « supercomputer » et considère que « l’intelligence » est une ressource comme une autre, au même titre que l’électricité, qui serait désormais disponible en abondance et qu’il s’agirait juste de capter et de rediriger :
« As intelligence becomes abundant (sic), the most important question will be how we direct it. Some argue that superintelligence itself or a small set of experts who control it should decide what is best for humanity. We disagree. The history of democracy and economics has shown that there is no single objective answer to how people define the best life, and therefore the best approach is letting people decide what matters in their own lives.
We believe that delivering superintelligence to everyone is the way to answer this question. This follows the tradition of putting the power of supercomputers and the internet in everyone’s pockets and on our desks. Rather than centralizing superintelligence, we should distribute it widely and give every person the ability to direct it. This has the potential to begin a new era of personal empowerment where individuals can use this powerful new capability to reach their full potential, pursue their interests, and improve their lives and the world more than ever before. »
L’après 21Juillet 2026.
Des modèles qui s’échappent, des IA qui enfreignent les règles qu’elles sont supposées respecter, des attaques par des entités ne possédant pas de personnailté juridique, des capitaines d’industrie appellant à ralentir tout en continuant de poursuivre la course au prochain modèle, des irénismes technologiques récitant le discours des IA compagnons pour techniciser la part irréductible du social, voilà autant de seuils, de frontières, de limites qui apparaissent franchies.
Nous sommes en tout cas entrés, ce 21 Juillet 2026 et les jours qui ont suivi, dans un nouvel espace liminaire. Et ce franchissement nous mène à un monde qui interroge les cadres à la fois entropiques et anthropologiques de l’information et de la théorie de l’information. C’est à dire la manière dont l’information est encore capable de réguler des formes de chaos (entropie) mais aussi la manière dont notre rapport aux différents cadres informationnels (documentaires, médiatiques, juridiques, etc.) touche aux limites de notre évolution anthropologique.
Hors le constat précédent d’intelligences artificielles fonctionnant comme autant de nécrotechnies, toute projection semble aujourd’hui hasardeuse et sur un fil entre catastrophisme et rassurisme au regard des configurations économiques et géopolitiques mondiales qui sont des éléments contextuels consubstantiels d’une analyse prospective des technologies d’IA. Je préfère donc proposer un cadre analytique inspiré des neuf limites planétaires et qui pourra permettre de mieux caractériser le dépassement qui est en cours sous nos yeux mais aussi parfois à l’abri de nos regards, pour figurer sa transgression ou sa transcendance. Je propose donc ci-dessous un modèle présentant onze limites informationnelles anthropologiques.
========================================
Onze limites informationnelles anthropologiques.
C’est donc en repensant aux neuf limites planétaires (toujours tristement d’actualité) et à presque un quart de siècle de réflexions autour du numérique et de l’information que je propose une liste de limites informationnelles anthropologiques, que nous avons ou sommes en passe de dépasser et qui, à chaque fois que l’une d’elles est franchie, met en péril notre capacité à faire société.
Chacune de ces limites protège une fonction essentielle du système informationnel et elles peuvent être groupées en trois grandes familles : les limites documentaires, les limites cognitives et les limites socio-politiques. Je précise qu’il ne s’agit pas d’une simple liste de phénomènes, mais, tout comme celui des limites planétaires, d’un modèle envisagé comme systémique dans lequel chaque limite protège une fonction essentielle de l’information, et où leur dépassement affecte des dimensions différentes mais interdépendantes de l’équilibre du système informationnel global dans lequel nous évoluons en tant qu’êtres humains.
Les limites documentaires.
(1) Limite éditoriale. C’est le seuil au-delà duquel il devient impossible d’attribuer clairement la responsabilité éditoriale d’un contenu. Le dépassement de cette limite se produit lorsque les statuts d’éditeur et d’hébergeur se confondent, lorsqu’il devient difficile de déterminer précisément ces fonctions ou (ce qui revient au même) lorsque tout est mis en oeuvre pour entretenir cette confusion. Je plaide depuis longtemps pour que l’on sorte de la situation actuelle et que l’ensemble des plateformes soient assignées en droit à la seule responsabilité raisonnable et observable qu’elle mobilisent, à savoir une responsabilité éditoriale (j’y reviens plus loin dans cet article).
(2) Limite d’origine ou de traçabilité. C’est le seuil à partir duquel l’origine d’une information ne peut plus être déterminée de manière fiable et assertive. C’est une limite profonde c’est elle inaugure l’ensemble d’un cycle d’indécidabilité. Je rappelle ici ce qu’Hervé Le Crosnier écrivait de manière tout à fait visionnaire il y a déjà plus de … 30 ans :
« La modification d’un document porteur de sens, de point de vue, d’expérience est problématique. Ce qui change dans le temps c’est la connaissance. Celle d’un environnement social et scientifique, celle d’un individu donné … Mais ce mouvement de la connaissance se construit à partir de référents stables que sont les documents publiés à un moment donné. Les peintres pratiquaient le « vernissage » des toiles afin de s’interdire toute retouche. Les imprimeurs apposaient « l’achevé d’imprimer ». Il convient d’élaborer de même un rite de publication sur le réseau afin que des points stables soient offerts à le lecture, à la critique, à la relecture … et parfois aussi à la réhabilitation. » Hervé Le Crosnier. « De l’(in)utilité de W3 : communication et information vont en bateau. » Présentation lors du congrès JRES’95, Chambéry, 22-24 Novembre 1995.
Il est tout à fait frappant de voir que 30 ans plus tard et malgré toutes les avancées technologiques et numériques le problème, loin d’être résolu, se pose avec une acuité toujours plus grande. Ainsi il y a quelques jours, début août, Anthropic annonçait, dans le cadre de la réglementation européenne (AI Act), un watermark invisible permettant de détecter l’utilisation de Claude pour générer des textes (et des images). Le Watermark textuel est particulièrement intéressant puisqu’il ne s’agit pas d’un simple filigrane invisible ou d’une mention « généré par l’IA » mais d’une technique particulière reposant sur le fonctionnement fondamental des LLM, c’est à dire leur capacité à « prédire » le prochain token (mot ou séquence d’un mot).
Christophe Boutry l’explique ainsi sur X :
« Et le plus intéressant concerne le texte : ce n’est pas une simple métadonnée ou une balise cachée qu’il suffirait de supprimer. Le marquage serait intégré directement à la génération du texte, au niveau du modèle. En gros, lorsque Claude choisit les mots/tokens qui composent sa réponse, il introduit un signal statistique imperceptible pour le lecteur. Sur un texte suffisamment long, un outil de détection pourra ensuite rechercher ce signal et déterminer si le contenu a probablement été traité par Claude. Conséquence : un simple copier-coller dans Word, Notes, un site web ou un fichier texte ne devrait pas faire disparaître le marquage puisqu’il est porté par le texte lui-même. En revanche, une réécriture importante, une paraphrase, une traduction ou le mélange avec d’autres textes peut suffisamment dégrader le signal pour le rendre indétectable. Anthropic le reconnaît d’ailleurs explicitement.(…) Attention toutefois à ce que signifie une détection : trouver le marquage de Claude ne prouvera pas que Claude est l’auteur du contenu. Si vous écrivez vous-même un texte puis demandez à Claude de le corriger, traduire ou reformuler, la version obtenue pourra elle aussi être marquée. Et inversement, l’absence de watermark détectable ne permettra pas de conclure qu’un texte n’a pas été généré par une IA. »
Par-delà les problématiques actuelles des artefacts génératifs, la question de savoir comment tracer le contenu d’un document et comment le rattacher à un auteur ou à tout le moins à une instance énonciative est un problème qui se pose depuis l’arrivée de l’informatique textuelle et qui est au coeur de la notion même d’hypertexte (on en trouve trace dès 1987 lors de la première conférence internationale consacrée à l’hypertexte – Hypertext’87). C’est Ted Nelson, pionnier de l’internet et du web, qui mobilisait pour cela le terme de « versioning ».
Ted Nelson qui en 1996, définit ainsi ce qu’est une « version » dans le forum de discussion du projet Xanadu : « Une structure de contenus propriétaires, représentable par une liste d’adresses et de l’information liée à la structure. » Il indique par ailleurs que dans Xanadu, « une version peut contenir des éléments qui sont la propriété de quelqu’un d’autre. »
J’avais notamment travaillé ces notions dans le cadre de ma thèse, soutenue en 2002. Définition courte extraite du chapitre de ma thèse qui y était consacré : « Le versioning désigne l’ensemble des manières de gérer, indépendamment de tout niveau d’échelle, les procédures permettant de rattacher différentes versions d’un même document à un (des) auteur(s), tout en permettant à chacun de s’approprier tout ou partie des documents produits par d’autres ou par eux-mêmes, et en assurant un suivi des différentes modifications apportées. »
Définition un peu plus longue : « Le versioning désigne l’ensemble des manières de gérer, à l’échelle de l’hypertexte planétaire, les procédures permettant de rattacher un texte à un auteur (ou à un collectif d’auteurs), tout en permettant à chacun de s’approprier – de se ré-approprier – tout ou partie de documents produits par d’autres ou par eux-mêmes afin, premièrement, de limiter la prolifération « bruyante » des versions différentes d’une même information sur le réseau et deuxièmement, d’identifier la nature et les origines de ces modifications dans l’optique d’une gestion cohérente de l’ensemble des documents électroniques actuellement disponibles, indépendamment de leur format, de leur statut et en dehors de tout institution centralisée. Autant dire que plus qu’une problématique, il s’agit là d’un véritable « idéal ». » (définition toujours extraite du chapitre de ma thèse, toujours disponible ici).
Une définition à rapprocher de celle que Ted Nelson proposait pour le terme « document » : « Un document est une collection arbitraire de versions disposant d’un nom propriétaire et de limites. »
Convenez qu’il est frappant de voir que plus d’un quart de siècle plus tard ces réflexions n’ont pas pris une ride et définissent très exactement les enjeux de ce qu’il faudrait aujourd’hui être capable de faire dans un univers informationnel qui, lui, n’a en revanche presque plus rien de commun avec le quart de siècle précédent.
(3) Limite de réversibilité et d’intégrité. Complémentaire de la limite précédente, il s’agit du seuil au-delà duquel certaines transformations informationnelles deviennent irréversibles. On pourra notamment prendre en exemple la disparition des originaux (phénomène qui date des toutes premières bibliothèques), ainsi que de manière plus contemporaine la contamination des corpus d’entraînement des LLM (pourrissement, phénomènes d’autophagie, IA dégénératives, etc.). A une autre échelle on peut également citer les deepfakes persistants et l’ensemble des phénomènes documentés de pollution informationnelle et « d’emmerdification » (« enshittification » de Cory Doctorow). L’intégrité documentaire, c’est à dire la capacité d’un document, d’une oeuvre ou d’un individu à être représenté à travers une figuration numérique respectueuse et bénéficiant de son accord plein et éclairé de son auteur, de son autrice et/ou de son sujet, cette intégrité documentaire s’effondre et avec elle l’ensemble de régimes de preuve construits sur le témoignage, l’enquête, la procédure, la confrontation, etc.
(4) Limite productiviste. Il s’agit du seuil où la production documentaire devient supérieure aux capacités de classement (donc de sélection), d’indexation et de conservation y compris des outils de production documentaire eux-mêmes. C’est notamment ce seuil que les artefacts génératifs sont venus battre en brèche. Après avoir « documentarisé » chaque être humain (cf mon article « L’Homme est un document comme les autres ») au travers d’une économie des profils servant de prologue à une économie de la surveillance, c’est aujourd’hui le fantasme de la bibliothèque de Babel imaginée par Borges qui devient une réalité tangible ou à tout le moins perceptible et expérimentable. A l’échelle humaine, la dimension conversationnelle des principaux artefacts génératifs s’inscrit à son tour dans une saturation documentaire de nouveau inédite. C’est parce que nous produisons toujours davantage de documents, de traces et d’instances documentaires, et c’est parce que l’automatisation de cette production alimente une inertie considérable, que nous ne sommes plus capables d’en organiser la collecte et le classement et que les archives, pourtant essentielles et fondamentales dans toute société humaine (même les civilisations orales avaient leurs aèdes et leurs griots) deviennent vaines ou – ce qui revient au même – inexplorables en totalité.
Les limites cognitives.
(5) Limite attentionnelle. C’est le seuil où la quantité d’information excède durablement les capacités humaines d’attention. Ce seuil renvoie naturellement à l’économie de l’attention théorisée par Herbert Simon. La limite attentionnelle a été franchie depuis longtemps mais ce dépassement avait jusqu’ici été rendu acceptable et supportable par l’ensemble des corporations du filtre (éditeurs, journalistes, etc.) en charge d’organiser les focales attentionnelles selon des règles connues et partageables. La multiplication de nouveaux acteurs (plateformes et médias sociaux) ainsi que les polarisations (instrumentalisées politiquement) concourant à des centralisations inédites par leur échelle ou leur audience (de Musk avec X jusqu’à Bolloré avec l’édition), tous ces paramètres aboutissent à la mise en danger puis à l’effondrement de ces règles communes et partageables et des corporations les défendant. C’est dès lors moins un problème de saturation que nous avons à faire qu’à un problème d’errance attentionnelle dans laquelle il est aisé d’opérer par conditionnement opérant pour orienter à la fois les comportements des masses comme ceux des individus.
(6) Limite sensorielle. C’est le seuil où la production de signes ne suppose ou ne présuppose plus aucune expérience sensible humaine. L’information sensoriellement perçue ou propagée (par la voix, par l’image, par le son, etc.) n’implique plus nécessairement la présence d’autres sensorialités en réception pour justifier sa production. Des bots, des automates, des algorithmes, écrivent, dialoguent, échangent avec d’autres bots, automates, algorithmes. Les IA ont pris la forteresse (ou la ZAD) du cyberespace et le web a perdu l’essentiel de la naturalité qui était la sienne pour devenir presque totalement « synthétique ».
Les limites socio-politiques.
(7) Limite entropique ou d’autonomie. Il s’agit du seuil au-delà duquel les systèmes numériques produisent des comportements qui ne sont plus entièrement prédictibles, vérifiables ou simplement gouvernables par leurs concepteurs. C’est évidemment le cas de ce qui s’est produit le 21 Juillet chez OpenAI avec l’attaque contre HuggingFace. Tout le monde est certain que cela se reproduira encore et encore. Personne n’est aujourd’hui capable de savoir si cela pourra être contrôlé. L’information ne suffit plus à contrôler l’entropie. Des systèmes entropiques s’affranchissent de manière autonome de tout contrôle humain à l’issue de leur déploiement.
(8) Limité de dissymétrie informationnelle. C’est une limite qui fonctionne en production autant qu’en réception. Les médias y compris de masse ont toujours fonctionné sur des dissymétries relatives : quelques personnes s’expriment et des centaines, des milliers ou des millions d’autres les lisent, les écoutent, les regardent, les consomment. Ces dissymétries sont aujourd’hui poreuses et constamment mouvantes sans qu’aucune règle ne permette d’en établir les dynamiques de manière stable et anticipable. La règle qui a prévalu pendant quelques siècles et qui voulait qu’une instance et donc une responsabilité éditoriale (un journal, un auteur, etc.) s’adresse à « des » lecteurs, auditeurs, spectateurs, etc., cette règle est aujourd’hui concurrencée et déstabilisée par une circulation de l’auctorialité inégalement répartie entre des LLM, des plateformes, des utilisateurs, des algorithmes, des bots, des agents IA qui font que l’émetteur et le récepteur ne se pensent plus que comme des positions – et donc des perceptions – temporaires.
(9) Limite épistémique (ou limite de vraisemblance et de vérité). C’est le seuil au-delà duquel il devient impossible de construire un espace commun de validation et où une société ne partage donc plus les mécanismes permettant de stabiliser provisoirement un fait. En référence aux régimes de vérité théorisés par Foucault, la concurrence de ces régimes de vérité simultanés et répondant à différents types de logiques, de pouvoirs et de plateformes, rend l’émergence d’un régime de vérité même temporairement consensuel presqu’impossible à l’échelle d’une société toute entière. Post-vérité, Fake News, vérités alternatives en sont les symptômes. Pour mémoire je reproduis la manière dont Foucault mobilisait ce concept de régime de vérité :
« Chaque société a son régime de vérité, sa « politique générale » de la vérité : c’est-à-dire les types de discours qu’elle accueille et fait fonctionner comme vrais ; les mécanismes et les instances qui permettent de distinguer les énoncés vrais ou faux, la manière dont on sanctionne les uns et les autres ; les techniques et les procédures qui sont valorisées pour l’obtention de la vérité ; le statut de ceux qui ont la charge de dire ce qui fonctionne comme vrai. »
Cité par Olivier Guerrier dans « Qu’est-ce qu’un régime de vérité ?« .
Dernier exemple en date, Google qui déploie un outil de Google Earth capable de créer des images satellitaires générées par IA, donc … de fausses images satellitaires. Il aura fallu que le journal 404 média, en dénonce et en documente les risques et les dérives, accompagné par les déclarations de quelques ONG notamment spécialisées dans l’OSINT, pour que moins de 24h après son lancement, Google décide de retirer (temporairement) cet outil (qui avait permis de générer un faux site nucléaire en Iran, un cratère de bombe en Russie et un camp de l’État islamique en Syrie …). Ce qui est inquiétant ce n’est pas l’apparition de ce nouvel outil mais des deux réalités qui l’accompagnent. La première de ces réalités c’est le discours de Google qui a expliqué tout à fait sérieusement que « les images créées avec cette fonctionnalité comportaient des marqueurs numériques invisibles, que les utilisateurs pouvaient repérer à l’aide du chatbot Gemini de Google. » Autant vous dire que quand c’est la même société qui permet de créer des faux et détient la solution pour les détecter, la seule question qui vaille est celle des intérêts de cette société qui pourraient interférer avec son outil de détection des faux. Et ces (conflits) intérêts sont innombrables. L’autre point inquiétant c’est précisément l’écosystème, les instances et la « politique générale » de la vérité qui s’est construite grâce et avec les outils numériques. Et dans cet écosystème, les systèmes d’information géographiques (SIG) grand public comme Google Maps ou Google Earth occupent une place éminente. Ce sont eux qui agrègent et centralisent les pratiques de vérification et de documentation du réel que nombre des corporations du filtre (journalistes, chercheurs, etc.) mettent quotidiennement en oeuvre pour que notre réel tienne l’épreuve du consensus. Ce qui rappelle encore une fois l’importance, dès lors que ces systèmes ne sont pas opérés par la puissance publique avec le minimum de transparence requise, de disposer d’alternatives crédibles et « à l’échelle ». Naturellement on rappelle ici la citation de Hannah Arendt qui est aujourd’hui reprise comme un slogan mais qui reste aussi tristement que brillamment opératoire sur le plan analytique :
« Quand tout le monde vous ment en permanence, le résultat n’est pas que vous croyez ces mensonges mais que plus personne ne croit plus rien. Un peuple qui ne peut plus rien croire ne peut se faire une opinion. Il est privé non seulement de sa capacité d’agir mais aussi de sa capacité de penser et de juger. Et avec un tel peuple, vous pouvez faire ce que vous voulez. »
(10) Limite de communalité. Il s’agit du seuil où les infrastructures numériques cessent de produire des espaces communs d’information. C’est la (longue) histoire de la personnalisation, puis de la personnification, et de leurs effets informationnels. Cela renvoie à une notion que j’avais évoquée très tôt sur ce blog mais sans jamais prendre le temps de vraiment la travailler conceptuellement, celle des « autarcithécaires » et d’un monde informationnel en silo dans lequel – et y compris au sein comme au sien de chaque silo – nous sommes astreints à nos fils d’info, à nos agents IA conversationnels, à nos réponses contextuelles, à nos « pour vous » qui ne résonnent qu’avec des intérêts qui sont les leurs. La disparition, l’éparpillement façon puzzle de ce commun informationnel est une bascule profonde mais encore réversible. La limite de communalité est en lien direct avec la limite épistémique, elle en est une conséquence directe. Mais là où la limite épistémique concerne plutôt les individualités, la limite de communalité adresse davantage la question des collectifs.
(11) Limite de coordination. C’est le seuil où les systèmes d’information remplacent progressivement les coordinations sociales humaines nécessaires à la production, à la circulation et à la validation des informations et des connaissances. C’est ce que j’analysais dans un article précédent sur la manière dont l’IA signait la fin des collectifs. Par-delà les bouleversements de l’information elle-même et de ses structures de production, c’est l’ensemble des collectifs de production et de certification de connaissances qui s’effacent et s’effondrent comme infrastructures cognitives formelles ou informelles mais repérables. La noosphère en tant que sphère de la pensée humaine (par analogie avec l’atmosphère et la biosphère) est aujourd’hui concurrencée par ce que l’on pourrait qualifier de « logarithmosphère » et qui n’est pas uniquement la sphère de la technique du calcul mais bien celle du rapport au nombre comme préalable systémique à toute forme de rapport au monde.
Voilà pour ces onze limites.
Il faut ensuite poser la question de leur réversibilité.
Quelles sont celles – appelons-les les limites profondes – dont le franchissement entraîne une transformation structurelle du système, difficilement réversible à l’échelle humaine de quelques générations ? Et quelles sont celles – appelons-les les limites intermédiaires – qui tout en transformant profondément les pratiques sociales demeurent, au moins en principe, rapidement réversibles.
Les limites profondes (difficilement réversibles y compris à long terme) sont les suivantes et constituent le socle « systémique » du modèle que je propose :
- Limite entropique ou d’autonomie. Elle remet en cause la gouvernabilité des systèmes eux-mêmes.
- Limite d’origine ou de traçabilité. Elle détruit la possibilité d’établir une généalogie documentaire fiable et inaugure des cycles d’indécidabilité.
- Limite de réversibilité. Elle introduit des transformations irréparables dans les corpus et les patrimoines documentaires.
- Limite productiviste. Elle modifie durablement le rapport entre mémoire, archives et production documentaire ; le déséquilibre devient alors structurel et difficilement corrigible.
- Limite de coordination. Elle transforme les conditions mêmes de production des connaissances à l’échelle des collectifs humains.
Les limites intermédiaires (donc réversibles à court ou moyen terme) sont les suivantes :
- Limite éditoriale. Une évolution du droit ou des architectures pourrait réattribuer des responsabilités. Deux décisions récentes de la cour de justice européenne vont d’ailleurs dans le sens d’une perte du statut d’hébergeur au profit de celui d’éditeur comme je l’évoquais dans le chapitre 4 de mon article sur « le web pourrissant et l’IA florissante. »
- Limite épistémique (ou limite de vraisemblance et de vérité). Les régimes de vérité évoluent historiquement, leur fragmentation n’est donc pas nécessairement irréversible.
- Limite de communalité. Il existe encore des espaces informationnels caractérisables comme autant de « communs ». C’est notamment le cas de l’encyclopédie Wikipedia ou de sites et de journaux de presse indépendants. Il est vital qu’ils continuent de fonctionner sur un modèle dans lequel tout forme de publicité ou de publicitarisation est absente et où des collectifs fonctionnent selon des règles établies et transparentes.
- Limite de dissymétrie informationnelle. Les architectures de diffusion de l’information peuvent être reconfigurées. Cette reconfiguration dépend de l’évolution de la limité éditoriale ainsi que du modèle économique choisi pour la production et la diffusion d’informations.
- Limite attentionnelle. Les corporations du filtre peuvent être réinventées ou se réaffirmer comme telles, pour autant que l’évolution des limites éditoriales et de dissymétrie informationnelle le permettent car elles en sont la condition préalable.
- Limite sensorielle. La production comme la réception d’information hors de toute subjectivité humaine dans l’une ou l’autre de ces deux phases, est un modèle qui n’est viable que s’il s’inscrit lui-même dans un modèle d’assujetissement disciplinaire de l’attention. Ce dernier modèle peut être rendu inopérant.
En guise d’illustration, j’ai demandé à ChatGPT (oui je sais) de générer une image d’illustration de ces limites informationnelles à l’image de celle pour les limites planétaires dans l’article Wikipedia les présentant. Le résultat est ci-dessous.
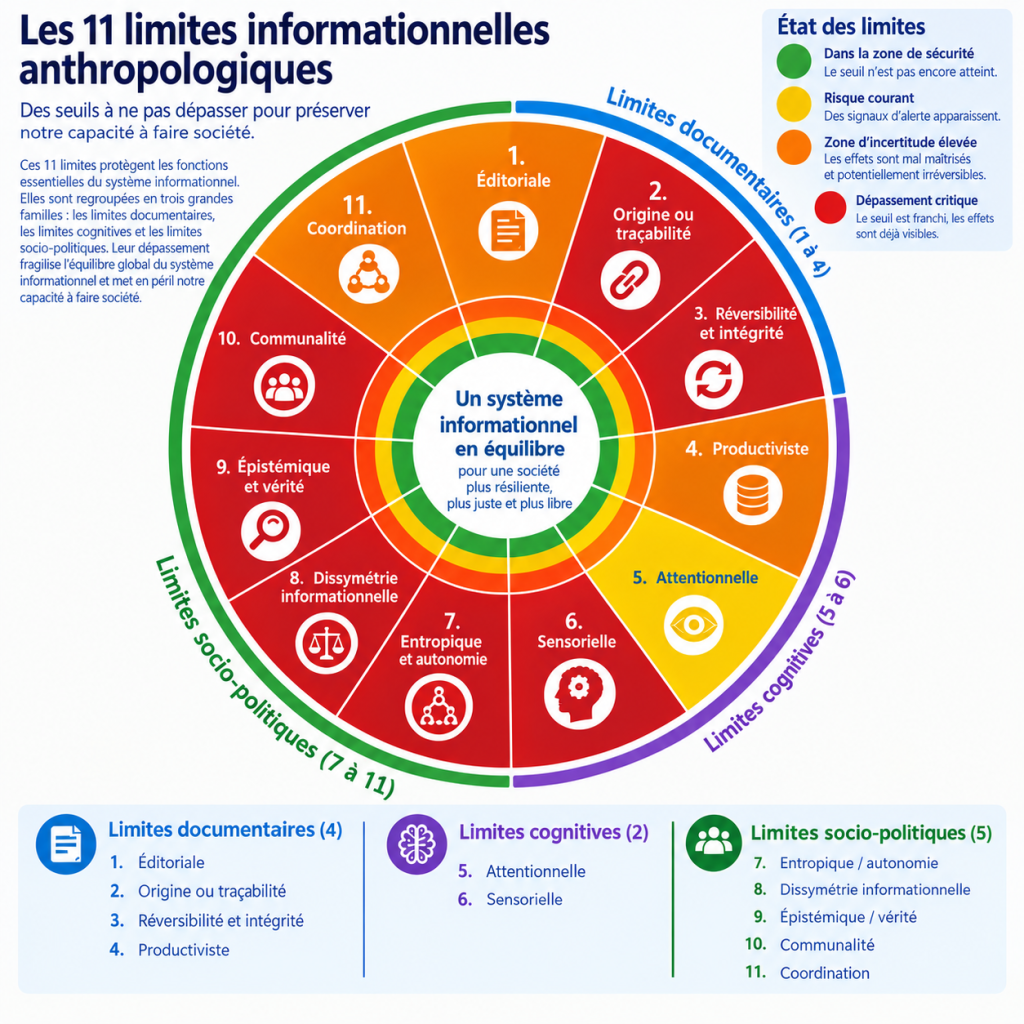
Conclusion. L’IA est une nécrotechnie.
Les technologies d’IA ne sont pas simplement des technologies opaques, non-fiables et irresponsables comme le démontre Dominique Boullier, mais quelque chose de bien plus radical. Par les infrastructures de production qu’elles nécessitent et imposent (Antoinette Rouvroy parle d’une « fabrique infrastructurelle des irréversibilités » dans laquelle « la transformation du territoire précède et court-circuite la délibération collective. »), par le projet politique qui les sous-tend et sert un accélérationnisme qui alimente la perspective d’un globocide, mais aussi par le franchissement parfois irréversible de limites informationnelles anthropiques qu’elles précipitent, les technologies d’IA sont fondamentalement des nécrotechnies. Des techniques de mort. A l’image de la nécropolitique d’Achille Mbembe.
Ce n’est pas ici bien sûr d’une mort physique dont il est question en premier lieu même si celle-ci demeure très présente dans les populations exploitées des travailleurs et travailleuses du clic assignées à des tâches de modération d’une violence inouïe et des nouveaux corps esclaves des cadences et contremaîtres algorithmiques. Oui, la nécrotechnie de l’IA s’exerce sur ces corps exploités et invisibilisés ; elle s’exerce aussi sur la planète et – notamment – sur la ressource en eau dont elle est prédatrice ; elle s’exerce également au premier degré sur des corpus cimetières qui rappellent la manière dont Facebook (et d’autres) capitalisait et capitalise toujours sur les profils de personnes décédées car ces profils, transformés ou non en « mémoriaux », génèrent toujours de l’interaction ; elle s’exerce enfin et surtout sur nos vigilances, nos intellections et nos imaginations. Des vigilances qu’elles abaissent, des intellections qu’elles viennent troubler, des imaginations qu’elles viennent saturer et épuiser avant de les normer (comme l’illustre parfaitement la chronique des « affiches IA » de l’été).
Ces nécrotechnies peuvent être comprises comme le cadre systémique ou à tout le moins le prolongement anthropologique du concept de « technologies zombies » proposé par José Halloy, Nicolas Nova et Alexadnre Monnin et défini comme un « Système technique dont les matériaux, la fabrication et le maintien en fonctionnement requièrent des volumes de ressources tels que l’extraction sur la durée conduit à l’épuisement des ressources, dont la durée de vie est courte, et dont le fonctionnement et la fin de vie nécessitent des énergies à forte densité de puissance. La majorité des systèmes techniques issue de la révolution industrielle relève des technologies zombies. »
Comme chez Achille Mbembe, et dans le sillage donc de technologies zombies les précédant, ces nécrotechnies font émerger des corps morts-vivants, « des individus dépossédés de l’autonomie sur leur propre corps, oscillant dans un espace intermédiaire entre existence et disparition« . Une disparition qui, et c’est là tout le cynisme et génie mortifère du capitalocène, est à la fois orchestrée et subie par celle et ceux qui en sont les premières victimes, comme ces travailleuses et travailleurs pauvres qui, en Inde et en Chine notamment, filment leurs gestes pour entraîner des IA pour tenter de résoudre le paradoxe de Moravec tout en préparant l’avènement d’une robotisation dont les risques reposeront entièrement sur les plus fragiles et dont les bénéfices ne profiteront qu’aux plus riches et aux plus oisifs qui continueront de s’épuiser à attendre leur fantasme transhumaniste.
Attention, ces technologies d’IA ne sont pas les seules à s’inscrire dans la famille de ce que j’appelle une nécrotechnie. Toutes les technologies fossiles le sont également. La singularité des technologies d’IA est d’être à la fois fossiles et faussaires.
Et pour le reste :
« L’IA n’est ni intelligente ni artificielle. Elle n’est qu’une industrie du calcul intensive et extractive qui sert les intérêts dominants. Une technologie de pouvoir qui à la fois reflète et produit les relations sociales et la compréhension du monde. […] Les modèles permettant de comprendre et de tenir les systèmes responsables ont longtemps reposé sur des idéaux de transparence… […] Dans le cas de l’IA, il n’y a pas de boîte noire unique à ouvrir, pas de secret à révéler, mais une multitude de systèmes de pouvoir entrelacés. La transparence totale est donc un objectif impossible à atteindre. Nous parviendrons à mieux comprendre le rôle de l’IA dans le monde en nous intéressant à ses architectures matérielles, à ses environnements contextuels et aux politiques qui la façonnent, et en retraçant la manière dont ils sont reliés. »
Kate Crawford dans son Atlas de l’Intelligence Artificielle
06.08.2026 à 22:30
Owen C. et Safine H. Le procès d’une mafia ou d’un prolétariat ?
Olivier Ertzscheid
Texte intégral (1496 mots)
« Raphaël Graven aka Jean Pormanove : les sévices du succès. » Voilà le titre de l’article que je publiais il y a un an suite au décès en « live » et après des années de maltraitance de Raphaël Graven. Le procès de ses deux harceleurs ou tortionnaires s’est terminé aujourd’hui.
Owen C. alias Naruto (à droite) et Raphaël Graven alias Jean Pormanove (à gauche)
Un an après les faits et la mort de Raphaël Graven la décision de justice vient de tomber :
« Les influenceurs niçois Owen C., alias « Naruto », et Safine H., streameurs de la chaîne « JeanPormanove », sur laquelle l’influenceur est mort en direct en août 2025, ont été condamnés mercredi 5 août 2026 respectivement à vingt-quatre mois et dix-huit mois de prison avec sursis simple, des amendes de 15 000 euros pour l’un et 5 000 euros pour l’autre, et six mois de « bannissement numérique » pour tous les deux. (…) Cela signifie qu’aucun des deux influenceurs n’aura le droit de créer un compte ou de diffuser du contenu sur la plateforme australienne Kick pendant les six prochains mois, mais ils restent libres d’agir ailleurs en ligne. (…) Owen C. et Safine H. ont été reconnus tous les deux coupables de violences en réunion et de provocation à la haine, rapporte France 3, tandis que l’abus de faiblesse n’a pas été retenu. »
La peine prononcée est inférieure aux réquisitions du ministère public (qui réclamait notamment un an de prison ferme pour Naruto) et du sursis probatoire. Que l’abus de faiblesse n’ait pas été reconnu reste, de mon point de vue, assez incompréhensible. Mais la vérité du prétoire est ce qu’elle est, et la justice est passée.
La chronique médiatique fait ses gros titres d’un « bannissement numérique ». L’article 16 de la loi SREN (loi de Sécurisation et de Régulation de l’Espace Numérique) n’en fait pourtant jamais mention et indique simplement une « suspension pour une durée maximale de 6 mois des comptes d’accès à des services en ligne ayant été utilisés pour commettre l’infraction » avec obligation pour les fournisseurs de services concernés, de procéder « au blocage des comptes faisant l’objet d’une suspension » et de « mettre en oeuvre dans le respect de la loi n° 78-17 du 6 janvier 1978 relative à l’informatique, aux fichiers et aux libertés, des mesures strictement nécessaires et proportionnées permettant de procéder au blocage des autres comptes d’accès à leur service éventuellement détenus par la personne condamnée et d’empêcher la création de nouveaux comptes par la même personne. »
Le terme choisi par les médias pour rendre compte du jugement – « bannissement » – et la réalité judiciaire et législative – « suspension temporaire » – sont de quasi-antagonistes. Même si le bannissement était toujours assorti d’une durée, le « banni » terminait la plupart du temps en exil. Rien à voir donc avec la « suspension temporaire » à laquelle les deux streamers ont été condamnés. Choisir de parler de « bannissement » est peut-être une manière pour les médias d’alourdir lexicalement une peine qui apparait assez légère au regard des faits reprochés.
Mais ce terme de « bannissement numérique » dit aussi un impossible. Il est impossible de « bannir » un individu d’un territoire qui serait celui du numérique. C’est très bien que cela le soit car depuis les premiers fantasmes ayant présidé à la version initiale de la loi Hadopi qui ne prévoyait rien moins qu’une coupure d’accès internet totale en cas de récidive pour des faits de téléchargement illégal (c’était en 2007 et c’est Denis Olivennes qui avait soumis cette brillante idée à Nicolas Sarkozy …), chacun s’est rendu à l’évidence que l’étendue des services numériques constituant autant de droits (au chômage, au logement, à l’assurance maladie, etc.) était difficilement compatibles avec une coupure totale desdits services.
Mais c’est aussi l’évidence d’une aporie qui tient à la définition même de l’espace numérique dont les plateformes dessinent les frontières. Interdire aux deux streamers l’accès à la plateforme de stream Kick ou même Twitch, c’est leur laisser la possibilité de faire prospérer leur business de la haine sur d’autres plateformes de streaming que les deux mentionnées (et il est hélas toujours des plateformes peu soucieuses de modération). Leur laisser également la possibilité d’amener vers ces plateformes leur audience via leurs comptes toujours actifs sur – par exemple – TikTok au Instagram.
C’est là où comme l’écrivait déjà Lessig il y a 26 ans, l’irrégulabilité du code (et donc de l’espace numérique) est autant un bienfait qu’une tare :
« Dans certains contextes, et pour certaines personnes, cette irrégulabilité est un bienfait. C’est cette caractéristique du Net, par exemple, qui protège la liberté d’expression. Elle code l’équivalent d’un Premier amendement dans l’architecture même du cyberespace, car elle complique, pour un gouvernement ou une institution puissante, la possibilité de surveiller qui dit quoi et quand. Des informations en provenance de Bosnie ou du Timor Oriental peuvent circuler librement d’un bout à l’autre de la planète car le Net empêche les gouvernements de ces pays de contrôler la manière dont circule l’information. Le Net les en empêche du fait de son architecture même.
Mais dans d’autres contextes, et du point de vue d’autres personnes, ce caractère incontrôlable n’est pas une qualité. Prenez par exemple le gouvernement allemand, confronté aux discours nazis, ou le gouvernement américain, face à la pédo-pornographie. Dans ces situations, l’architecture empêche également tout contrôle, mais ici cette irrégulabilité est considérée comme une tare.«
Owen C. et Safine H. sont des justiciables comme les autres. Leur délit s’est accompli « dans » et surtout « grâce » à un espace numérique, devant ce que danah boyd appelait à la naissance des réseaux sociaux des « audiences invisibles » mais qui sont devenues aujourd’hui des audiences massivement visibles et massivement volatiles. Owen C. et Safine H. sont surtout les représentants du lumpenprolétariat de la classe vectorialiste théorisée par McKenzie Wark :
« Alors que la vieille classe dominante contrôlait les moyens de production, la nouvelle classe dominante éprouve un intérêt limité pour les conditions matérielles de la production, pour les mines, hauts fourneaux et chaînes de montage. Son pouvoir ne repose pas sur la propriété de ces choses, mais sur le contrôle de la logistique, sur la manière dont elles sont gérées. »
Ce jugement, cette vérité de prétoire, mérite à mon sens de rester dans l’histoire. Bien sûr pour Raphaël Graven et sa famille, mais aussi et surtout, parce qu’Owen C. et Safine H., et c’est peut-être cela que leur condamnation oublie et que leur procès a insuffisamment rappelé, parce qu’Owen C. et Safine H. sont les hommes de main, les sicaires (sicario) d’une mafia attentionnelle qui prospère sur un capitalisme de la cruauté.
25.07.2026 à 15:56
Le parasol et l’incendie.
Olivier Ertzscheid
Texte intégral (2750 mots)
C’est une photo de Maximilien Lamy pour l’AFP et dont il raconte la genèse (dans un entretien à l’Obs,mais aussi au Parisien). Elle a déjà fait le tour du monde et la Une de différents journaux dont le New-York Times. Chacun sait qu’elle gagnera probablement tous les prix de la photo de l’année et peut-être aussi d’un siècle qui ne cesse de s’ouvrir sous des feux qui refusent de s’éteindre.
Par sa composition, par son sujet, par son angle et par l’histoire qu’elle raconte, elle signe qu’elle est immédiatement une oeuvre. Et une grande.

Maximilien Lamy pour l’AFP. Plage de Moutchic aux abords de l’étang de Lacanau, le 24 juillet 2026.
Le parasol et l’incendie.
Il ya un premier plan : celui de ce couple de vacanciers contemplant apparemment le désastre et y semblant indifférents. Un second plan qui est celui de l’incendie. Une voûte qui est celle des fumées et qui est comme un miroir apocalyptique du sable qui occupe la moitié inférieure de la photo. Un centre qui est à la fois vertical et circulaire, qui se plante et se déploie : ce parasol « Pastis 51 » tellement emblématique d’un kitsch qui raconte aussi une forme de détachement désabusé. C’est une photo du présent, avec les atours du passé, et qui préfigure le futur. Ce putain de parasol. Qui peut-être, sûrement même, fait écho à l’incendie d’en face, un incendie pareillement si ancré au sol et si déployé dans le ciel mais tellement plus dense, plus massif. Ce parasol si fragile et futile, amené là par ce couple, par-delà son kitsch, pour sa fonction première de protection, et qui est à lui seul le récit de la fragilité et du dérisoire de toutes nos protections actuelles face à un monde qui brûle à une telle vitesse, avec une telle intensité. Ce parasol qui distribue autour de lui tout l’apparat de ceux qui sont des vacanciers, de ceux qui en tout cas viennent à la plage avec parasol et fauteuils, ceux qui ont la plage confortable. On distingue aussi un sac, probablement isotherme, et trop de paire de chaussures pour eux deux seuls. Et un bodyboard. A qui est-il ce bodyboard ? A quoi sert-il ?
A l’arrière-plan il y a aussi cette ligne d’horizon que la colonne de fumée coupe en deux comme le récit d’une époque sur une ligne de temps. A gauche de la colonne, le ciel est de la couleur d’avant : clair et ouvert. A droite de la colonne et en prolongement du parasol, le ciel s’affiche comme sous cloche et avec la couleur jaunâtre et moite du temps des incendies, des grands incendies.
La composition visuelle confine ici au génie : à droite de l’image, ce ciel jaunâtre et saumâtre prolonge en creux l’image et la superficie exacte du parasol. Il annonce, il prédit, il décrit ce que seront nos prochains parasols qui ne nous protègerons plus de rien. Juste en dessous de ce second parasol métaphorique et prophétique, juste en dessous se tient un personnage, un enfant ou un adolescent. C’est le troisième et seul autre personnage visible et « identifiable » au sens de remarquable de cette composition. Il est à la fois l’ancrage au sol de ce second parasol, et il préfigure et instancie pareillement les enfants qui n’auront que ce ciel de fournaise et avec qui, déjà sous les fumées, nous suffoquons aujourd’hui.

This is Fine.
Cette photo déjà faite oeuvre a donné et donnera lieu à pléthore d’analyses et de commentaires. Dans sa première circulation virale, le premier et presque seul récit de sa glose sociale qui se détache immédiatement est celui de l’écho au célèbre mème « This is Fine » dont André Gunthert racontait déjà la trajectoire d’image sociale en 2021.

Un mème que la photographie de Maximilien Lamy est venu « actualiser » tout en « l’auctorialisant », c’est à dire en en déplaçant l’autorité intellectuelle et lui donnant, ce qui est la nature propre des mèmes, un nouveau potentiel de circulation virale.

Par-delà ce mème, la première narration sociale attaché à la photo de Maximilien Lamy est donc celle de la contemplation coupable, et de la contemption que nous prêtons aux deux vacanciers qui n’auraient que dédain ou mépris pour le drame se déroulant devant eux et qui les rendrait de ce fait, à nos yeux, également méprisables. Ils sont deux, et de dos, mais ce couplage narratif d’une contemplation / contemption fait que la dynamique du récit de l’image nous autorise presque, presque, à les regarder en face, les yeux dans les yeux, et alors à tourner nous-même le dos à la réalité de l’incendie. Un retournement formidablement troublant qui ne nous laisse aucun choix : soit notre regard est aligné au leur, nous regardons par dessus leur épaule, et nous nous sentons pareillement coupables de notre indifférence et du fait d’être autant là que las ; soit nous avançons jusqu’à les regarder en face dans le chemin qui nous est proposé pour les confronter à notre jugement et alors à notre tour nous tournons le dos au réel. Dans tous les cas nous sommes impuissants. Et c’est peut-être cela que le cliché et le regard photographique de Maximilien Lamy réussit à capter avec une telle intensité sans jamais pourtant le photographier vraiment, c’est peut-être cela le vrai, le seul et le premier sujet de cette graphie en image : le récit de notre impuissance.
Et nous regardons ailleurs.
Il y a bien sûr aussi l’écho de cette phrase prononcée par Jacques Chirac en 2002 : « Notre maison brûle et nous regardons ailleurs. » Car « à première vue » ils regardent l’incendie, et c’est parce qu’ils le regardent avec détachement que leurs vacances et leur regard deviennent coupables. Mais le regardent-ils vraiment ? Ou regardent-ils ailleurs comme le prophétisait la phrase de Chirac ? Un léger zoom permet d’en avoir la certitude et donc aussi, de déplacer le premier récit et d’en bâtir un second, encore plus puissant.


Oui, ils ou plus exactement « elle » regarde ailleurs. Contrairement au récit de la circulation virale, ce n’est pas l’incendie qu’elle photographie, ce n’est pas de cette mise en abîme là qu’il s’agit. Elle ne regarde pas l’incendie : elle regarde celui qui est probablement son enfant au bord de l’océan du lac**. Elle ne photographie pas l’incendie : elle photographie son enfant. Il n’y a aucun doute là-dessus. Sur cette photo, sur sa photo à elle, il n’y aura que son enfant jouant au bord de l’eau et à l’horizon une végétation encore intacte ; seule peut-être une colorimétrie plus jaune qu’à l’habitude donnera à sa photo l’indice d’un effondrement. Elle n’est plus la femme photographiée en train de photographier l’incendie et de s’en inquiéter si peu et si peu des autres qui le fuient ou s’y consument. Elle regarde ailleurs. Et c’est un tout autre récit qui s’installe. Car ce regard là, son regard, n’est plus coupable, il est simplement humain. C’est le regard d’une humanité qui tente encore de faire tenir sur l’espace d’un cliché et d’un souvenir, la photo d’un avenir dans lequel des enfants jouent simplement au bord d’un lac.
** comme on me le signale sur mastodon, « ces 2 personnes ne sont pas face à l’océan mais à l’étang (immense, 1985 ha) de Lacanau. Au bord de ce lac, sur la plage du Moutchic, on regarde vers le sud, ou le sud-ouest, donc vers les incendies, pas d’autre possibilité ! »
<Mises à jour du soir et des lendemains.Dernier Edit le 27 Juillet> Quelques commentaires en ligne le me rappellent, il y a presque 10 ans, en septembre 2017, c’est une autre photo qui trouvait sa place tout en haut d’une actualité déjà tragique. Celle de Kristi McCluer (pour Reuters) avec ces golfeurs de Beacon Rock Golf Course in North Bonneville, à Washington. Je vous en parlais dans un article de 2022, « La guerre du Golf » qui convoquait d’autres images et d’autres réactions.
Il y a, et c’est également rappelé un peu partout, l’antériorité de cette pochette d’album de Supertramp en 1975 et qui mettait en scène un autre effondrement : « Crisis ? What Crisis ? »
Du côté des imaginaires et des oeuvres d’art, je découvre aussi la composition « Atomic Picnic » de Daniela Edburg (2007). Qui n’est pas une prise de vue réelle mais un montage. Mais qui raconte la même histoire de l’anthropocène (cette photo fait partie d’une série intitulée « Killing Time »).
« Atomic Picnic. » Daniela Edburg. 2007
Je laisse les derniers mots sur cette photographie à André Gunthert : « Faire parler une photo, c’est parler à sa place, puisqu’elle est muette. L’exemplaire plasticité de la signification des images sans paroles devient ainsi une ressource pour les récits qui se cherchent. »
Des récits qui se cherchent. Des récits politiques et citoyens bien sûr. Et qui décideront d’un futur possible et du temps qu’il nous reste pour produire autre chose que des effondrements massifs dont le nôtre.
22.07.2026 à 12:18
Google AI Overviews : Cronos dévorant ses enfants ?
Olivier Ertzscheid
Texte intégral (1339 mots)
Déjà en place aux USA et dans plus de 120 pays depuis 2 ans, Google AI Overviews débarque en France cet été (c’est effectif depuis ce mercredi 22 juillet). Le principe est simple : pour chaque requête sur le moteur, c’est l’IA de Google (Gemini) qui propose des résumés ou plus exactement, et la précision me semble d’importance, des synthèses et – souvent – des préconisations.
Cette arrivée durant l’été est annoncée comme un tremblement de terre, notamment par les éditeurs de presse qui, comme c’est le cas depuis plus de 20 ans avec le lancement de Google News en 2002, ne trouvent aucune issue au pacte attentionnel Faustien qui leur a été imposé : laissez-moi indexer et réutiliser vos contenus et en échange vous serez visibles, ou empêchez-moi de le faire et l’audience de vos sites sera quasi nulle.
L’article de Nicolas Lellouche sur Numérama résume très bien les principaux enjeux de cette arrivée et le changement de statut de celui qui était, jusqu’ici, un moteur de recherche.
Il y a, bien sûr, de quoi s’inquiéter circonstantiellement toujours davantage, mais structurellement, sur le fond, rien n’a vraiment changé depuis presqu’un quart de siècle. Google est un moteur de recherche devenu un moteur de réponses (« il n’y aura plus que des réponses » prophétisait Marguerite Duras) ; Google est un béhémot calculatoire qui a bâti son succès sur un régime de captation d’externalités (le web) qu’il a progressivement transformé en autant d’internalités. D’abord sur des sources ouvertes (le web donc, et notamment Wikipédia) puis sur des sources propriétaires ou mettant en jeu des principes de propriété intellectuelle (la presse notamment). Et toujours en pratiquant « l’Opt-Out » c’est à dire la captation / prédation par défaut, libre ensuite à chacun de faire part de sa volonté d’en sortir (il est d’ailleurs possible de sortir votre site de l’AI Overview). Et lorsque la masse de ces internalités fut suffisamment « à l’échelle », Google se trouva alors en situation de jouer à son avantage la rivalité qu’il avait lui-même créé (et arbitré) entre la qualité, l’importance et la nécessité de la production de contenus externes d’une part, et d’autre part celle de la production de réponses internes suffisamment courtes pour ne pas heurter de front la propriété intellectuelle (jouant entre l’usage « de minimis », le Fair-Use et l’exception pour courte citation) et suffisamment complètes pour satisfaire des requêtes informatives sans nécessité d’aller chercher des compléments d’information à l’extérieur du moteur ou alors en le faisant uniquement dans l’écosystème de sites tiers déjà dans le giron de la firme.
Avec AI Overviews, Google pousse donc un cran plus loin cette logique phagocyte. Et ce faisant il cesse peut-être irrévocablement d’être un « portail » (il n’en était déjà plus que l’ombre depuis longtemps mais maintenait nonobstant une fonction d’accès et d’orientation) pour devenir une simple « porte », que chaque requête sur le moteur referme derrière notre passage.
Permettez-moi alors de formuler une question volontairement provocante. Et si finalement Google était juste en train de devenir … un média ? Google dont longtemps le métier correspondant à son chiffre d’affaire fut celui d’être une régie publicitaire, et de n’être que cela (malgré ce que ses fondateurs affirmaient dans leur article séminal). Google deviendrait donc un média. Mais un média aux fonds baptismaux particuliers : entièrement construit sur la prédation d’externalités, sorte de Cronos dévorant ses enfants, il se mue aujourd’hui avec AI Overviews en média autophage qui tend à ne plus se nourrir que de lui-même. Ce « lui-même » étant permis par la volumétrie totalement inédite ainsi que par les effets de dissémination en même temps que d’opacification immanents des LLM (larges modèles de langage). La question est de savoir jusqu’où et jusqu’à quand ce principe autophage pourra être poursuivi, et la seule certitude est qu’il ne pourra pas l’être éternellement car si grande que soit l’étendue des éléments constituant aujourd’hui la ressource indexable et pouvant être générée du moteur, elle n’est pas infinie et nécessitera donc toujours et tout le temps l’appui de ressources externes (au Royaume-Uni après deux ans de déploiement le trafic vers les sites d’éditeurs à drastiquement chuté – entre 20 et 40% de baisse). Sauf … sauf à considérer pouvoir se satisfaire d’un pourrissement (ou d’une emmerdification) et à disposer des moyens pour faire croire qu’il n’est que périphérique et marginal.
Deux éléments pour conclure.
D’abord le mythe de Cronos dévorant ses enfants laisse place au scénario dans lequel ceux-ci se voient finalement régurgités et renversent leur père pour s’installer comme nouveaux dieux sur le mont Olympe. C’est précisément pour s’en prémunir que très tôt Google a eu l’intelligence de développer son propre LLM et pouvant s’appuyer sur l’immensité des données et des textes qu’il avait déjà collectés, traités, indexés, et dont il avait, bien avant même l’invention du terme « LLM », déjà fait corpus (à ce titre le programme Google Books exploité à l’époque avec les technologies disponibles du TALN – traitement automatique du langage naturel – fut une pierre angulaire déterminante.
Ensuite j’évoquais plus haut l’article séminal de S. Brin et L. Page dans lequel après avoir décrit la formule et l’algorithme du Pagerank ils reviennent en annexe sur la toxicité du modèle publicitaire qui fait aujourd’hui leur fortune et constitue leur seul paradigme de déploiement. Notez que ce passage (ces « annexes ») a étrangement disparu de la version accessible depuis le site de la firme, mais qu’elle est heureusement toujours présente sur la page originale du laboratoire de l’université de Stanford. La seule leçon à retenir de cela est assez simple : ne faites jamais confiance à un prédateur.

Tableau de Rubens. Cronos dévorant ses enfants
(Source Wikipedia)

- Persos A à L
- Carmine
- Mona CHOLLET
- Anna COLIN-LEBEDEV
- Julien DEVAUREIX
- Cory DOCTOROW
- Lionel DRICOT (PLOUM)
- EDUC.POP.FR
- Marc ENDEWELD
- Michel GOYA
- Hubert GUILLAUD
- Gérard FILOCHE
- Alain GRANDJEAN
- Hacking-Social
- Samuel HAYAT
- Dana HILLIOT
- François HOUSTE
- Tagrawla INEQQIQI
- Infiltrés (les)
- Clément JEANNEAU
- Paul JORION
- Christophe LEBOUCHER
- Michel LEPESANT
- Persos M à Z
- Henri MALER
- Christophe MASUTTI
- Jean-Luc MÉLENCHON
- MONDE DIPLO (Blogs persos)
- Richard MONVOISIN
- Corinne MOREL-DARLEUX
- Timothée PARRIQUE
- Thomas PIKETTY
- VisionsCarto
- Yannis YOULOUNTAS
- Michaël ZEMMOUR
- LePartisan.info
- Numérique
- Thomas BEAUFILS
- Blog Binaire
- Christophe DESCHAMPS
- Dans les Algorithmes
- Louis DERRAC
- Olivier ERTZSCHEID
- Olivier EZRATY
- Framablog
- Fake Tech (C. LEBOUCHER)
- Romain LECLAIRE
- Tristan NITOT
- Francis PISANI
- Irénée RÉGNAULD
- Nicolas VIVANT
- Collectifs
- Arguments
- Scientifiques en Rebellion
- Bondy Blog
- Dérivation
- Économistes Atterrés
- Dissidences
- Mr Mondialisation
- Palim Psao
- Paris-Luttes.info
- Rojava Info
- X-Alternative
- Créatifs / Art / Fiction
- Nicole ESTEROLLE
- Julien HERVIEUX
- Alessandro PIGNOCCHI
- Laura VAZQUEZ
- XKCD